Los mismos bits en cualquier máquina
Un filtro de ponderación diseñado por phonometry es el mismo filtro, byte a byte, sean cuales sean la biblioteca C, el BLAS, el LAPACK, el número de hilos o la semilla de hash con que se diseñe, sea cual sea el compilador con que se construyó numpy, y en cualquier procesador: x86-64 con o sin AVX-512 o multiply-add fusionado, y ARM de 64 bits. En el camino de diseño no queda ningún paso de biblioteca. Cada trascendente que toma el ajuste está escrita en aritmética que IEEE 754 fija o calculada correctamente redondeada en aritmética entera exacta, así que glibc, la libm de Apple, musl y el runtime de Windows, y las rutinas de glibc para x86-64, compiladas con multiply-add fusionado o sin él, no tienen voz en sus bits. Los dos pasos de fuera del ajuste que antes pasaban por una biblioteca numérica son también aritmética propia del paquete: los polos del prototipo de BS.468-4, que hallaba LAPACK, son las raíces correctamente redondeadas del polinomio exacto de la red, y las secciones de segundo orden, que SciPy formaba a través del BLAS, son el procedimiento del propio SciPy con cada producto redondeado una vez y cada módulo correctamente redondeado. Esta página registra lo que se fijó y mide lo que hace. Los coeficientes que diseña un portátil son los que diseña un clúster, así que un veredicto de conformidad, una figura publicada o un filtro embarcado en una cadena de medida es un artefacto reproducible y no el relato de una máquina sobre sí misma.
Esa frase no es el comportamiento normal del Python científico, y esta página registra lo que costó, con los números.
Por qué la coma flotante deriva entre hosts
Sección titulada «Por qué la coma flotante deriva entre hosts»IEEE 754 fija cada operación individual: dados dos dobles, su suma, resta, producto, cociente y raíz cuadrada son el mismo patrón de bits en toda máquina conforme. Todo lo que va más allá de una operación es por donde se escapa la reproducibilidad, por tres puertas distintas.
Las reducciones pueden reasociarse. Una suma de muchos términos no tiene orden definido, y un BLAS elige el que conviene a los registros vectoriales que encuentra en tiempo de ejecución. phonometry midió lo que eso cuesta sobre su propio ajuste de ponderaciones: dos juegos de kernels de OpenBLAS coincidieron en todas las decisiones de aceptación de la búsqueda de Levenberg-Marquardt durante treinta y nueve pasos consecutivos mientras los costes que comparaban derivaban de 3 × 10⁻¹³ a 1 × 10⁻⁴ de separación, y las dos ejecuciones aterrizaron después en filtros distintos: 5 × 10⁻⁵ de separación en el coeficiente principal, 0,002 dB en respuesta, unos visibles 0,0225 pt en una curva dibujada. Un optimizador en un valle plano amplifica lo que haga el último bit.
Las trascendentes vectorizadas se despachan. numpy elige los kernels de
log, exp, tan, power, arctan y sin según lo que ofrece la CPU, y
los kernels AVX-512 no coinciden hasta el último bit con los que corre una
máquina sin AVX-512. Medido bajo Intel SDE emulando Skylake-X contra el mismo
host en nativo: cada una de esas seis devuelve un digest distinto sobre las
mismas entradas. La fuga llega más lejos que los sitios de llamada obvios:
numpy.geomspace es 10 ** linspace(...), así que la propia rejilla de
frecuencias sobre la que se evalúa cada residuo del ajuste salía distinta
bajo AVX-512, y todos los pasos aguas abajo la heredaban.
La libm de la plataforma es una elección de plataforma. math.log es el
log que traiga la biblioteca C. El de glibc y el de Apple son ambos exactos
hasta cerca de media ulp, lo que significa que en un puñado de entradas
redondean legítimamente a vecinos opuestos, así que un bucle de diseño
construido sobre math.log devolvía filtros distintos en macOS y en Linux
sin nada en ningún sitio que lo dijera. Lo mismo valía para cualquier otra
trascendente que traiga la biblioteca C, y por eso la ponderación A a
48 kHz llegó a dar tres digests en las tres plataformas de la matriz de
CI.
Qué fija phonometry
Sección titulada «Qué fija phonometry»El camino de diseño determinista responde a cada puerta en su terreno, en
filters._weighting_design y los módulos fijados que lee,
_internal.pinned_log, _internal.pinned_exp y _internal.pinned_trig:
- Sus propias reducciones. Cada suma que el ajuste compara o con la que
resuelve se pliega por pares en una forma que fija el código, y las
ecuaciones normales se resuelven por eliminación gaussiana escrita a mano,
el mismo algoritmo que corre el
dgesvde LAPACK con el orden ya fuera de la elección de una biblioteca. El plegado por pares es además el orden más exacto: un redondeo O(ε log n) contra el O(ε n) de un acumulador corrido, así que no se sacrificó nada. - Aritmética real donde la compleja se despacha o se fusiona. El
producto complejo y el módulo complejo fusionan operaciones de forma
distinta por CPU, y el producto y el cociente complejos de numpy son
bucles de C que un compilador puede fusionar en multiply-adds: numpy
compilado con clang, como en macOS y Windows, lo hace, y numpy compilado
con GCC, como en Linux, no. Así que cada punto donde el camino entregaba a
numpy o a SciPy una expresión compleja está escrito en aritmética real,
los pasos de numpy en el orden de numpy, cada uno redondeado una vez: la
curva impresa a la que apunta el ajuste, la lectura que fija la ganancia
que se entrega y la transformada bilineal con su ganancia, que
bilinear_zpkde SciPy forma como un producto de números complejos. - Trascendentes fijadas. Dentro de la iteración, el logaritmo corre tres
cuartos de millón de veces por diseño, la exponencial una vez por factor y
por evaluación, y la potencia una vez por punto de la rejilla en cada
ronda de Lawson. Cada una es la propia rutina de glibc deletreada en
operaciones numpy que IEEE 754 fija exactamente, aritmética simple,
trabajo de bits enteros y consultas de tabla: el
logde tablas y ellog10construido sobre él, y elexpy lapowde optimized-routines de ARM tal como glibc los compila para un procesador con multiply-add fusionado, cada multiply-add que fusiona esa compilación reproducido por una emulación exacta (redondeo a impar, según Boldo y Melquiond). Elsin, que se toma dos veces por diseño, latan, tres, la arcotangente, una vez por diseño sobre los 257 puntos de la rejilla de frecuencias, y el módulo de una raíz compleja salen correctamente redondeados: el double más cercano al valor exacto, hallado en aritmética entera exacta con el bucle de Ziv. Sus bits son suyos en toda máquina, que es más fuerte que llamar a la libm de nadie, y en el ajuste no queda ninguna rutina de la biblioteca C. Para la arcotangente eso tuvo un precio en Linux: la de glibc redondea al otro lado 19 de las 15 866 arcotangentes que evalúan los diseños comprobados, así que el valor correctamente redondeado movió seis de los 133 diseños comprobados en sus últimos bits. La rutina de glibc, que los habría dejado donde estaban, es la IBM Accurate Mathematical Library, con licencia LGPL-2.1-or-later, y no se transcribe en este paquete MIT. - La rejilla deletreada. La rejilla geométrica de frecuencias se genera término a término con los extremos fijados, así que el ajuste evalúa las mismas frecuencias en todas partes.
- Ningún paso de biblioteca fuera del ajuste. Los seis polos del
prototipo de BS.468-4 eran las raíces polinómicas de numpy: valores
propios de la matriz compañera, que LAPACK halla con una iteración cuyas
sumas el BLAS y el compilador pueden ordenar y fusionar a su gusto. El
denominador de la red se construye ahora a partir de sus siete valores de
componente en aritmética racional exacta, y sus raíces se hallan también
en aritmética exacta y se redondean una sola vez, cada parte al double
más cercano a la de la raíz exacta, decidido por un certificado: un disco
alrededor de cada aproximación que contiene, demostrablemente, una raíz y
ninguna otra, y una extensión en cada coordenada que cae estrictamente
entre los puntos medios que rodean a un double, o una coordenada que la
aritmética exacta muestra sobre uno de esos puntos medios, y que se
redondea al par. Las secciones de segundo orden eran el
zpk2sosde SciPy, que forma el polinomio de cada sección connumpy.convolve, cuyos productos complejos van al BLAS, y empareja polos con ceros por el módulo complejo propio de numpy, que no está correctamente redondeado. Ahora está escrito paso a paso y rama a rama, cada producto y cada suma redondeados una vez y cada módulo correctamente redondeado; de dos ceros exactamente a la misma distancia de un polo toma el primero, como hace una ordenación estable, donde la elección de SciPy pasa por la ordenación por defecto de numpy, cuyo orden de empates depende del procesador.
El mismo camino como una sola columna, en el orden en que lo recorre el código, cada etapa junto al paso de biblioteca que sustituyó:
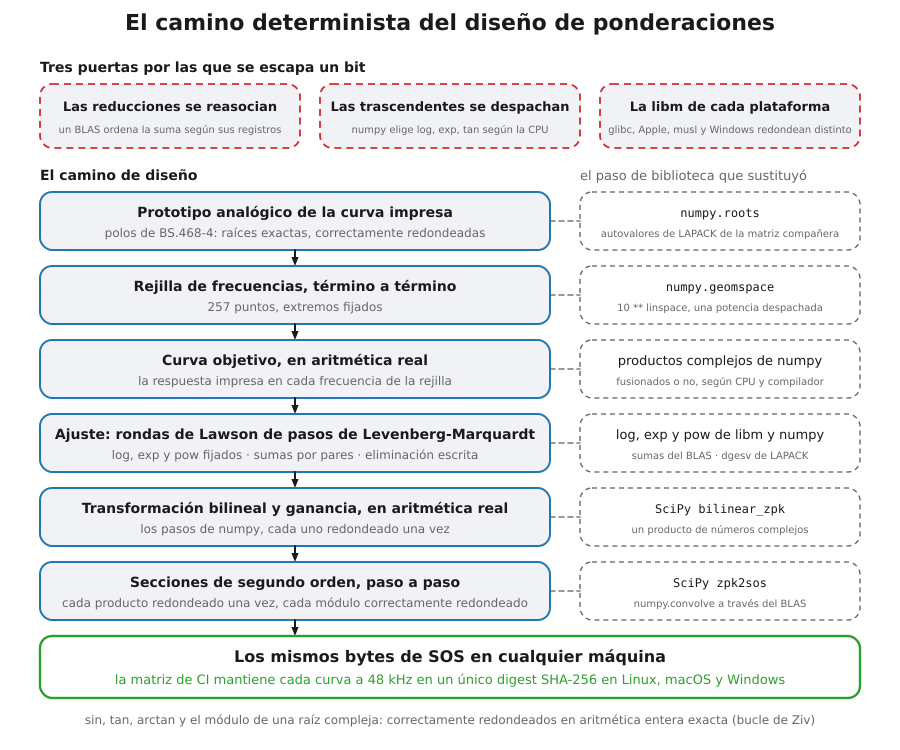
El orden es el del código, no el de la lista de arriba. El prototipo va primero, porque el ajuste parte de sus polos, así que los dos pasos que la lista nombra al final quedan uno a cada lado del ajuste: los polos de BS.468-4 antes y las secciones de segundo orden después. Los recuadros discontinuos de la derecha son lo que llamaba antes cada etapa, y las tres puertas se cierran por el camino: la rejilla y las trascendentes fijadas cierran la segunda y la tercera, las sumas por pares y la eliminación escrita cierran la primera, y la aritmética real le quita los productos complejos al compilador que puede fusionarlos o no.
La evidencia
Sección titulada «La evidencia»Cada afirmación de arriba está medida, y la mayoría las re-miden tests que corren en CI:
- 91.658.333 entradas, cero excepciones. Cada valor distinto que el
corpus de diseño entero pasa a su logaritmo se capturó y se comparó bit a
bit contra el
logde glibc: idéntico en todos, más alrededor de cien millones de sorteos adversariales sobre el rango completo de exponentes, la banda cercana a uno, los números subnormales (los «denormalizados» de la literatura clásica) y los bordes de las ramas. Una búsqueda adversarial encontró también el límite honesto: en torno a una entrada de cada treinta millones, en una banda estrecha, cuyo logaritmo verdadero queda a media ulp de ambos vecinos y donde las dos implementaciones se separan en el último bit. Ninguna puede alcanzar un diseño, porque en el camino de diseño la rutina fijada es la definición. - El corpus se movió donde lo hizo la arcotangente, y en ningún otro
sitio. Los diseños de siete curvas a diecinueve frecuencias de muestreo,
133 en total, dan el mismo SHA-256 único antes y después de vectorizar el
logaritmo, y otra vez después de fijar la exponencial, la potencia, el
logaritmo decimal,
sin,tany los módulos complejos. La arcotangente correctamente redondeada movió después seis de ellos en sus últimos bits: las ponderaciones A y C a 44,1 y 88,2 kHz, la D a 88,2 kHz y la G a 1,5 kHz. Las 19 arcotangentes que glibc redondea mal llegan a 32 de los 133 diseños; en los otros 26 la frecuencia que difiere en una ulp da el mismo nivel objetivo hasta el último bit, así que el ajuste nunca la ve. Con la arcotangente de glibc de vuelta, el corpus da otra vez su SHA-256 anterior, y los seis que se movieron siguen dentro de las cotas de respuesta que sostienen los tests. - Los dos últimos pasos de biblioteca movieron 21 diseños en Linux, y ningún otro. Escribir los polos y las secciones movió los diecinueve diseños de BS.468-4, cuyos polos las raíces correctamente redondeadas sitúan a entre 2 y 36 unidades en el último lugar de cada parte de los de LAPACK. El ajuste parte de los polos, y desde un arranque a unas pocas unidades se asienta en otros coeficientes dentro de su tolerancia: se mueven entre 7 y 13 de los 18 de cada diseño, en sus últimos 9 a 12 bits a 250, 400 y 500 Hz y a 22,05 kHz en casi la mitad del valor de un coeficiente pequeño, y la respuesta difiere como mucho 0,0072 dB, a 125 Hz (0,0033 dB a 44,1 kHz, 0,000012 dB a 48 kHz). Movió la ponderación AU hasta dos unidades en el último lugar de ocho coeficientes a 100 Hz y una unidad de seis a 200 Hz, donde el módulo complejo de numpy, a una unidad del correctamente redondeado, emparejaba al revés dos ceros separados por una unidad en el último lugar. Los otros 112 diseños comprobados conservan sus bytes, entre ellos la ponderación A a las diecinueve frecuencias, y todo diseño que se movió sigue dentro de las cotas de respuesta que sostienen los tests.
- Los polos, contra el valor exacto. Los seis polos son las raíces que halla una biblioteca de precisión arbitraria, redondeadas parte a parte, y la batería de tests los sostiene en esos doubles. Contra esa misma biblioteca a 3000 bits, el buscador de raíces tal como se publica devolvió el valor correctamente redondeado de cada parte de cada raíz de 10 600 polinomios aleatorios, cada uno en menos de medio segundo: 10 200 copias de la red 468 con cada componente movido hasta un 30 %, 200 de coeficientes enteros de grado dos a diez, cuatro de ellos con una raíz en cero, y 200 cuyas raíces se reparten en dieciocho décadas. La respuesta de numpy difiere de ellos entre 4 y 21 unidades en el último lugar del módulo de la raíz, como mucho un 3 % del error que el solucionador de valores propios de LAPACK, estable hacia atrás, se permite en esa matriz compañera, así que los polos son lo que halla numpy, dentro del error del propio numpy, y los mismos bytes en todas partes. En CI el buscador de raíces se contrasta con raíces escritas en forma cerrada y redondeadas con raíces cuadradas enteras exactas, un método que él no usa.
- Las secciones, contra las de SciPy. Si se le dan módulos
correctamente redondeados, el
zpk2sosde SciPy devuelve las secciones del diseño bit a bit en el prototipo simple y en el ajustado de cada uno de los 133 diseños comprobados, con la compilación de numpy que redondea sus productos complejos paso a paso; con los módulos propios de numpy solo se separa de ellas en la AU a 100 y 200 Hz, como arriba, y las dos realizan la misma respuesta hasta 10⁻⁹ dB en cada curva. Con el producto escalar complejo del BLAS fusionado por emulación, las secciones de SciPy para la ponderación D a 48 kHz se mueven hasta 11 unidades en el último lugar y las del diseño no se mueven nada. - La exponencial y la potencia, bit a bit. Cada valor distinto que el
corpus pasa a
exp(677 596) y apow(580 455) devuelve los bits de glibc, y también cada uno de 120 millones de sorteos sobre el dominio de cada rutina, con los bordes del desbordamiento y del subdesbordamiento y los resultados subnormales. La emulación del multiply-add fusionado devuelve elfmade la biblioteca C en cada uno de 30 millones de sorteos, la mitad casi cancelándose. - La arcotangente, contra el valor exacto. La arcotangente fijada devuelve el double correctamente redondeado, calculado de forma independiente por una biblioteca de precisión arbitraria a 200 bits, en cada uno de los 15 866 valores distintos que le pasan los diseños comprobados, en 572 386 valores de borde (cada potencia de dos desde el subnormal más pequeño hasta el double más grande con 64 vecinos a cada lado, los ceros con signo, los infinitos, NaN y las dos bandas donde la respuesta deja de ser el argumento o el double más cercano a π/2), en 60 millones de patrones de bits aleatorios sobre toda la recta de los doubles y en 150 millones de sorteos cuya magnitud está entre 2⁻⁶² y 2⁶², donde la rutina hace su trabajo de verdad. Con la primera pasada recortada a 56 bits, donde entre un cuarto y un tercio de las entradas necesita una segunda y solo la cota de error decide, otros 60 millones de sorteos salen también correctamente redondeados, y esa cota, comparada con el valor exacto en un millón de evaluaciones a cinco precisiones de trabajo, nunca se usó más que a medias. En CI las respuestas se comprueban con cotas racionales exactas sobre la tangente, sin evaluar ninguna arcotangente.
- Correctamente redondeado, donde glibc lo está y donde no. En los 70
valores de
sin, los 105 detany los 67 módulos complejos que evalúa el corpus, glibc devuelve el valor correctamente redondeado, así que las rutinas correctamente redondeadas devuelven ahí sus bits; en 19 de sus arcotangentes no lo hace, como se dice arriba. Fuera del corpus la coincidencia descansa en la precisión de glibc y no en una prueba: de todas las frecuencias de muestreo enteras entre 100 Hz y 200 kHz, 5 864 de los 1 399 307 diseños (frecuencia, curva) encuentran unsino unatanque glibc redondea al otro lado, y 45 526 leen un nivel objetivo que la arcotangente de glibc cambia, y esos diseños pueden moverse en Linux al fijarlas, en lo que una ulp crece a través del ajuste. De las frecuencias habituales que deja fuera el conjunto comprobado, 50 kHz para A, B, C y D y 100 kHz para AU encuentran unsino unatan(AU pasa de7ee0fe06b2a91373aec6c060d4b27d1b9), y 176,4 kHz para A, B y C la arcotangente. - Ninguna biblioteca C. Con cada resultado de veinte rutinas de la
biblioteca C empujado una unidad en el último lugar, mediante una capa
entre Python y la biblioteca C (las exponenciales, los logaritmos, la
potencia, las funciones trigonométricas e hiperbólicas y sus inversas, e
hypot), el corpus entero, ajustado y simple, da los mismos dos SHA-256 que sin ella, mientras que con el código anterior a la arcotangente fijada cada uno de doce diseños medidos así (la ponderación A a 48, 44,1, 88,2 y 192 kHz, la C a 44,1 y 88,2 kHz, la D a 48 y 88,2 kHz, la G a 1 y 1,5 kHz, y la 468 y la AU a 48 kHz) se movía. musl, otra biblioteca C, diseña el corpus entero con el SHA-256 de glibc sin sustituir nada, y lo mismo la compilación de glibc sin FMA. En ARM de 64 bits, la familia de procesadores de la pata de macOS de la matriz de CI, en emulación con glibc y con musl y el OpenBLAS que numpy trae ahí, los 133 diseños son los bytes de x86-64; hasta que se escribieron los dos últimos pasos de biblioteca, 33 de ellos se separaban ahí, los diecinueve diseños de BS.468-4 en los polos y otros catorce en las secciones. - Digest a digest entre entornos. Los diseños son bit-idénticos entre este host y el mismo host bajo emulación AVX-512, bajo cada juego de kernels de OpenBLAS seleccionable, cada número de hilos y cada semilla de hash; las comparaciones entorno contra entorno están fijadas como tests.
- Un digest en tres plataformas. Con solo el logaritmo fijado, la
ponderación A a 48 kHz daba
991833ff389afe91en Linux (glibc, x86-64),4efa1818bd80e23aen macOS (arm64) y79852a57e60961c8en Windows (x86-64). Con todas las trascendentes fijadas aún daba5f5e34e5d3a8aa6een macOS y en Windows, un mismo valor para los dos: la transformada bilineal de SciPy tomaba la ganancia como un producto de números complejos, por el bucle de numpy que clang fusiona y GCC no. Un test que fusiona esos productos y cocientes en cualquier plataforma reproduce ese digest con el código que llamaba a SciPy, y con la transformada escrita en aritmética real diseña991833ff389afe91, y con ella sin cambios los diseños bilineales simples de todas las curvas a 48 kHz. Un test de la matriz de CI diseña la ponderación A tal como se entrega, sin sustituir nada, y la sostiene en991833ff389afe91en las tres plataformas, la ponderación A a 44,1 kHz endbea4b7fc4ad972b, y cada una de las demás curvas a 48 kHz en un digest propio; un segundo test diseña las dos otra vez con una arcotangente que no le debe nada a la rutina fijada, la respuesta de la biblioteca C llevada hasta el double correctamente redondeado con cotas racionales exactas, y cae en los mismos digests. Con glibc en x86-64 sin FMA la ponderación A a 48 kHz daba43f786ffab5c4dd4antes de fijar las rutinas, y la segunda compilación de la arcotangente aún separaba nueve de los 133 diseños comprobados de la compilación con FMA hasta que se fijó; las dos compilaciones diseñan ahora el corpus entero con un mismo SHA-256. Los tests de respuesta que corren en esas tres plataformas sujetan el diseño A a 0,013 dB de su prototipo analógico en 20 001 frecuencias de su banda de ajuste, en cada una de las seis frecuencias de muestreo que comprueban; dos plataformas cuyos bytes aún difirieran podrían diferir hasta el doble, 0,026 dB, en una de esas frecuencias.
Compruébalo tú
Sección titulada «Compruébalo tú»Dos diseños son el mismo diseño, y los bytes tienen nombre:
import hashlibfrom phonometry import filters
una = filters.WeightingFilter(48000, "A").sosotra = filters.WeightingFilter(48000, "A").sosprint(una.tobytes() == otra.tobytes())                   # Truedigest = hashlib.sha256(una.tobytes()).hexdigest()print(digest[:16])                                       # 991833ff389afe91
La segunda línea es la clave: esos dieciséis dígitos hexadecimales, la cabeza del SHA-256, no son «lo que salió en mi máquina», son el digest de la ponderación A a 48 kHz de esta versión en cualquier máquina, el que la matriz de CI sostiene por igual en Linux, macOS y Windows. Si una versión futura mueve un coeficiente a propósito, el digest se mueve con ella y el cambio es un suceso documentado, nunca una propiedad de tu hardware.
Alcance
Sección titulada «Alcance»La garantía cubre el camino de diseño determinista de ponderaciones de punta a punta, para cada curva y cada frecuencia de muestreo, en cualquier plataforma: ningún paso es de una biblioteca, y la matriz de CI sostiene cada curva a 48 kHz en un mismo digest en Linux, macOS y Windows. El procesamiento por bloques compone con ella: una cascada con estado alimentada bloque a bloque es bit-idéntica a una sola pasada sobre el registro entero, así que el streaming no gasta la garantía. Las funciones de análisis generales construidas sobre numpy y SciPy en su forma corriente siguen siendo reproducibles en una misma máquina pero pueden diferir en los últimos bits entre CPUs, que es la condición normal del Python científico; el tratamiento determinista se aplica donde importa la identidad de un filtro.
Tampoco fuera del ajuste queda nada de una biblioteca. Los polos del prototipo de BS.468-4 y las secciones de segundo orden fueron los dos últimos pasos que lo eran, las raíces que hallaba LAPACK y las secciones que SciPy formaba a través del BLAS, y en ARM de 64 bits con OpenBLAS separaban 33 de los 133 diseños comprobados de los bytes de x86-64; los dos son ahora aritmética propia de este paquete, medida al diseñar cada uno de los 133 con los mismos bytes en x86-64 con glibc, con y sin FMA, y con musl, y en ARM de 64 bits con glibc y con musl. El diseño ya no llega al Accelerate de Apple, que enlaza la compilación de numpy para macOS, así que los bytes de macOS se afirman para cada curva y los sostiene el test de CI.
El relato de ingeniería completo vive con el código, en los docstrings de
módulo de
filters/_weighting_design.py,
_internal/pinned_log.py,
_internal/pinned_exp.py,
_internal/pinned_trig.py
y
_internal/pinned_roots.py,
y los tests que lo sostienen están en
tests/filters/test_weighting_design.py
y los cuatro tests/test_internal_pinned_*.py.
Véase también
Sección titulada «Véase también»- Informe de conformidad: contra qué se comprueban los números; esta página es la razón de que las comprobaciones lean igual en todas partes.
- Erratas de las fuentes publicadas: la otra mitad de la historia de la evidencia: donde lo que está mal es el valor esperado impreso.
- Ponderaciones en frecuencia: la guía de las curvas que realiza el diseño determinista.
- Procesamiento por bloques: la identidad de streaming en la que se apoya la sección de alcance.