Primeros pasos
phonometry es una biblioteca de Python para la medida acústica, desde los
bancos de filtros de fracción de octava y la ponderación frecuencial hasta los
niveles sonoros y las métricas normalizadas. Cada métrica se verifica frente a
la norma que la rige: 1899 comprobaciones numéricas en total.
Instálala con pip install phonometry; el primer ejemplo de abajo filtra una
señal en tercios de octava y devuelve el nivel de presión acústica de cada
banda, y el apartado siguiente ancla esos niveles a un tono de calibrador, que
es lo que los convierte en una medición.
Instalación
Sección titulada «Instalación»Las órdenes de abajo son las de pip. Entornos trata uno a uno uv, conda, Jupyter, JupyterLite, Docker y los comprobadores de tipos.
Desde PyPI (recomendada)
Sección titulada «Desde PyPI (recomendada)»pip install phonometrySi ya tienes instalada phonometry 3.x, actualízala con
pip install -U phonometry, con los extras que uses
(pip install -U "phonometry[full]" para los cuatro donde [full] se
instala); la 3.x organiza sus imports de otra manera y en ella
from phonometry import filters falla. El código escrito para la 3.x
necesita cambios para funcionar con la 4.x; la
guía de migración recoge cada uno.
phonometry necesita Python 3.12 o posterior, con NumPy 2.0.2 y SciPy 1.14.0
o versiones más recientes. Cada una de esas versiones mínimas, y cada mínima de
los extras, es la más antigua con la que pasan los tests de la biblioteca, y un
trabajo de CI instala exactamente esas versiones en Python 3.12 para que siga
siendo así: matplotlib 3.10.7 para [plot], reportlab 4.3.0 y svglib 0.9.1
(salvo la 1.4.0) para [report], numba 0.60.0 para [perf], python-soundfile
0.12.0 para [audio] y torch 2.3.0 con array-api-compat 1.5.1 para [torch].
Python 3.13 y 3.14 tienen mínimas propias para NumPy, SciPy, numba y torch,
cuyas versiones más antiguas no tienen wheel para ellos: las más antiguas que
sí lo tienen, que el mismo trabajo instala en cada uno, en Python 3.13 NumPy
2.1.0, SciPy 1.14.1, numba 0.61.0 y torch 2.5.0, y en Python 3.14 NumPy 2.3.2,
SciPy 1.16.1, numba 0.63.0 y torch 2.9.0. El wheel de Python 3.13 de
torch 2.5.0 es solo para Linux en x86-64, donde corre el trabajo; en macOS en
ARM, Windows en x86-64 y Linux en ARM el primero es torch 2.6.0, el más
antiguo que se instala allí.
Windows en ARM, Linux con musl, macOS en Intel y Windows de 32 bits no tienen
wheel en algunas de esas mínimas, y pip, ceñido a ellas, compila allí esas
versiones desde el código fuente, lo que requiere compiladores. En Windows en
ARM los primeros wheels son NumPy 2.3.0, SciPy 1.16.2 y numba 0.68.0 (0.67.0
en Python 3.14), así que se compilan todas las mínimas de las tres salvo la de
NumPy en Python 3.14. En Linux con musl, como en Alpine, el primer wheel de
SciPy en ARM para Python 3.12 y 3.13 es el 1.15.2, matplotlib no publica ningún
wheel para musl en ARM, así que [plot] lo compila allí, y numba, con el
llvmlite que necesita, no publica ningún wheel para musl, así que [perf] se
compila desde el código fuente en cualquier sistema con musl. En macOS en Intel
numba no publica wheel desde la 0.63.0, ni llvmlite desde la 0.46.0, y numba ya
no prueba esa plataforma, que deja al soporte de su comunidad, así que [perf]
compila los dos en la mínima de Python 3.14; sus últimos wheels allí, numba
0.62.1 y llvmlite 0.45.1, son para Python 3.12 y 3.13. En Windows de 32 bits
NumPy tiene wheel en todas las mínimas, pero el último wheel de SciPy allí es
el 1.9.1, para Python 3.9 como mucho, así que incluso una instalación normal
compila SciPy allí en todos los Python, y la propia compilación de SciPy avisa
allí de que se instale un Python de 64 bits. matplotlib no publica wheel para
Windows de 32 bits desde la 3.8.0, ni kiwisolver, que necesita, desde la 1.4.8,
así que [plot] compila los dos allí. numba dejó de dar soporte a Windows de
32 bits en la 0.58.0, por debajo de la mínima de [perf], y sus últimos wheels
allí, numba 0.57.1 y llvmlite 0.41.1, son para Python 3.10 como mucho, así que
[perf] no tiene soporte allí, ni [full], que lo incluye;
pip install "phonometry[plot,report,audio]" instala allí los otros tres
extras. Lo mismo vale para Linux de 32 bits, donde los últimos wheels de
numba, de la 0.56.4, son para Python 3.10 como mucho y numba ya no da soporte
a la plataforma; Docker y
servidores dice qué compilan allí
los otros tres. Una instalación normal toma las versiones más recientes, que
tienen wheels en las otras tres plataformas salvo numba en musl y en macOS en
Intel, donde una instalación normal de [perf] compila numba y llvmlite en
todos los Python, y matplotlib en ARM con musl. PyPI no tiene wheel de torch
para ninguna de las cuatro (el último para macOS en Intel es el 2.2.2,
anterior a todas las mínimas, y para Windows de 32 bits nunca ha habido
ninguno) y torch no publica distribución de código fuente, así que [torch]
no se instala en ellas desde PyPI. En Windows en ARM el índice de CPU de
PyTorch tiene wheels de torch para Python 3.12, desde la 2.7.0, y 3.13, desde
la 2.8.0, así que instalar antes torch desde él, como se explica más abajo,
trae [torch] allí; no tiene ninguno para Python 3.14 allí, ni para Linux con
musl ni para Windows de 32 bits, y para macOS en Intel ninguno posterior al
2.2.2, como en PyPI. python-soundfile, para [audio], no publica ningún wheel
que lleve libsndfile para Linux con musl, ni en su mínima 0.12.0 para Linux en
ARM, cuyo primero es el 0.13.0, ni para Windows en ARM, cuyo primero es el
0.14.0, así que pip instala allí su wheel de Python puro, que carga la
libsndfile del sistema: en Alpine, apk add libsndfile-dev, porque el Python
de la imagen oficial de Docker solo encuentra esa biblioteca con el nombre
libsndfile.so, que añade ese paquete.
Extras opcionales
Sección titulada «Extras opcionales»pip install "phonometry[plot]" # matplotlib, para gráficas de respuesta y métodos .plot() de resultadospip install "phonometry[perf]" # numba, ponderación temporal 'impulse' más rápidapip install "phonometry[report]" # reportlab + svglib, para que los métodos .report() generen fichas PDF normativas (su panel de gráfica necesita también [plot])pip install "phonometry[audio]" # python-soundfile, para que phonometry.io lea también FLAC, AIFF, Ogg/Opus, MP3 y WAV comprimidopip install "phonometry[full]" # todos los anteriores (recomendado)pip install "phonometry[torch]" # torch + array-api-compat, para que las simulaciones FDTD calculen con PyTorch (CPU, CUDA o MPS de Apple); [full] no lo incluyeRecomiendo pip install "phonometry[full]": instala de una vez matplotlib,
numba, reportlab, svglib y soundfile, con lo que quedan habilitadas todas las
funcionalidades de la biblioteca salvo el cálculo de las simulaciones FDTD con
torch, que añade [torch]. En Windows y Linux de 32 bits, donde [full] no
tiene soporte, pip install "phonometry[plot,report,audio]" instala los otros
tres, como se dice más arriba, y compila desde el código fuente SciPy,
matplotlib y kiwisolver en Windows, y NumPy, SciPy, matplotlib y Pillow, entre
otros, en Linux. La instalación base calcula todas las métricas solo
con NumPy y SciPy. Esto incluye leer con phonometry.io todo WAV lineal de
medición (24 bits, multicanal EXTENSIBLE, RF64); lo único que no queda
disponible son las figuras (.plot() y las gráficas de respuesta de los
filtros), las fichas PDF normativas (.report()), el núcleo compilado que
acelera la ponderación temporal impulse, los demás formatos de audio (FLAC,
AIFF, Ogg/Opus, MP3 y WAV comprimido) y el cálculo de las simulaciones FDTD con
torch (que se calculan con NumPy de todos modos, y en una GPU de NVIDIA en
cuanto se instala CuPy). Un apunte de licencias sobre [audio]: instala
python-soundfile, cuyo wheel empaqueta libsndfile bajo LGPL-2.1 (enlazada
dinámicamente, el mismo patrón que librosa y torchaudio), y que carga la
libsndfile del sistema donde ningún wheel la lleva, como se dice más arriba. La
instalación base
se mantiene libre de ella a propósito, y por eso los formatos metrológicos no
necesitan extra.
Un matiz sobre [full]: numba es el único extra que pone un tope a NumPy, y
solo lo sube cuando pasa a admitir una versión menor nueva de NumPy. Por eso,
en las semanas siguientes a una versión menor de NumPy, phonometry[full]
(igual que phonometry[perf]) puede resolver una versión menor por detrás de
lo que obtiene una instalación simple. numba solo acelera la ponderación
temporal impulse, de modo que si necesitas la última versión de NumPy el
mismo día que sale, instala phonometry[plot,report] y deja fuera [perf].
numba guarda el núcleo compilado en disco, junto al paquete o bajo tu directorio
personal, para que un proceso posterior lo cargue en lugar de compilarlo de
nuevo. Donde ninguno de los dos admite escritura, como en una cuenta de servicio
o un usuario de contenedor sin directorio personal, lo compila una vez en cada
proceso; apunta NUMBA_CACHE_DIR a un directorio con permiso de escritura para
conservarlo.
[full] deja fuera [torch] a propósito: los wheels de torch que sirve PyPI
para Linux traen gigabytes de bibliotecas de CUDA. En una máquina Linux sin
GPU de NVIDIA, instala primero torch desde el índice de CPU de PyTorch y
después el extra, que conserva el torch que encuentra, y esas bibliotecas se
quedan fuera; en Windows en ARM, donde PyPI no tiene torch, las mismas dos
órdenes traen [torch] en Python 3.12 y 3.13:
pip install torch --index-url https://download.pytorch.org/whl/cpupip install "phonometry[torch]"Añadir ese índice con --extra-index-url no basta: pip toma el torch más
reciente que encuentra en cualquiera de los dos índices, también el de
PyPI con CUDA.
Dónde se calcula una simulación explica qué necesita cada dispositivo de las simulaciones FDTD, entre ellos el wheel de CuPy para una GPU de NVIDIA, y pip y uv qué trae cada extra y cómo los instala uv.
Desde un clon
Sección titulada «Desde un clon»git clone https://github.com/jmrplens/phonometry.gitcd phonometrypip install .pip construye el wheel sin compilador; pip y uv cuenta el resto.
Como submódulo de git
Sección titulada «Como submódulo de git»git submodule add https://github.com/jmrplens/phonometry.git# Después, instálalo en modo editable para usarlo desde tu proyectopip install -e ./phonometryLa cadena de procesado de un vistazo
Sección titulada «La cadena de procesado de un vistazo»Todo análisis con phonometry es un subconjunto de una misma cadena: tomar la señal en bruto, convertirla a unidades físicas, ponderarla en frecuencia, dividirla en bandas normalizadas, suavizarla en el tiempo y reducirla a métricas:
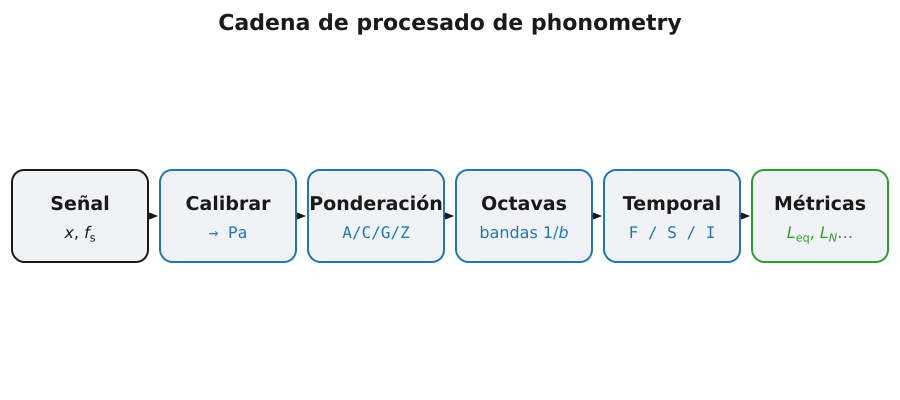
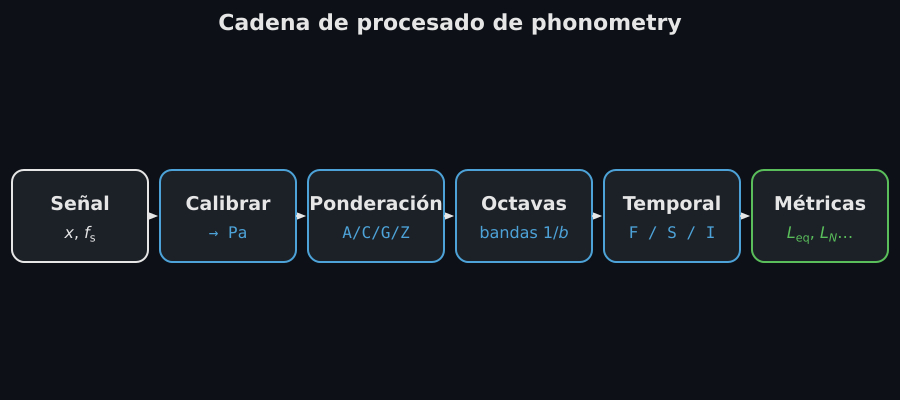
Léela como una secuencia de decisiones y no como una receta fija. La calibración va primero porque todo lo que viene después es un cociente respecto a 20 µPa, así que un factor de escala equivocado desplaza todos los números posteriores en la misma cantidad y nada de lo que viene detrás puede detectarlo. La ponderación frecuencial la define IEC 61672-1 como un único filtro aplicado a la señal de banda ancha; aplicar en su lugar correcciones de ponderación banda a banda después del banco es un atajo que solo se sostiene para una señal estacionaria. El banco decide la resolución en frecuencia, y la balística y las métricas deciden el comportamiento temporal, actuando las dos sobre la señal ponderada y en ese orden, porque la ponderación temporal exponencial eleva la señal al cuadrado y por tanto no conmuta con nada de lo anterior.
El ejemplo del apartado siguiente recorre Señal → Octava y nada más: sin calibración, así que sus niveles son pascales por hipótesis y no por medición; sin ponderación, así que son Z (sin ponderar); sin balística, así que cada banda es un único valor eficaz sobre todo el registro. «Dar sentido físico a las muestras», más abajo, devuelve la primera etapa a su sitio, y cada etapa es una función o clase independiente que puedes usar por separado; las guías las recorren de izquierda a derecha (Calibración → Ponderación frecuencial → Bancos de filtros → Ponderación temporal → Niveles).
Un primer análisis: bandas de tercio de octava (sin calibrar)
Sección titulada «Un primer análisis: bandas de tercio de octava (sin calibrar)»Divide una señal en bandas de tercio de octava y lee el nivel de cada una.
import numpy as npfrom phonometry import filters
fs = 48000t = np.linspace(0, 1, fs, endpoint=False)# Señal compuesta: 100 Hz + 1000 Hzsignal = np.sin(2 * np.pi * 100 * t) + np.sin(2 * np.pi * 1000 * t)
# Aplicar el banco de filtros de 1/3 de octavaresult = filters.octave_filter(signal, fs=fs, fraction=3)
print(f"Bandas: {result.frequencies}")# Bandas: [12.589254117941678, 15.848931924611138, ..., 19952.623149688785]  (33 bandas)print(f"SPL [dB]: {result.levels}")# SPL [dB]: [46.77640002 47.81719048 48.93133762 ...]# la banda de 100 Hz lee 90,71 dB y la de 1 kHz 90,94 dB
Las frecuencias de banda salen como números, no como las etiquetas de un
analizador. IEC 61260-1 sitúa las frecuencias centrales sobre una rejilla en
base 10, con para los tercios de octava,
que es por lo que la más baja es 12,589 Hz y la más alta 19 952,6 Hz. Los
números redondos que imprime un sonómetro de mano son las designaciones
nominales que la misma norma da a esas mismas bandas: pasa nominal=True y
freq vuelve como ['12.5', '16', …, '20k'], que es lo que quieres en un eje o
en un informe, mientras que los valores exactos son lo que quieres para
calcular. Hay 33 bandas porque el rango por defecto va de 12 Hz a 20 kHz;
limits=[f_min, f_max] lo estrecha, y estrecharlo suele merecer la pena:
consulta Bancos de
filtros para la rejilla.
Lee el espectro antes de fiarte de él. Dos de las 33 bandas contienen la señal: 90,71 dB a 100 Hz y 90,94 dB a 1 kHz, ambas a menos de 0,3 dB de 90,97 dB, el nivel de una sinusoide de amplitud unidad leída como pascales (). Esa coincidencia es la comprobación de que el banco hace una aritmética defendible; el pequeño déficit en 100 Hz es la respuesta del filtro de banda diezmado en su propio centro, no energía perdida. Todo lo demás de la gráfica es el banco de filtros mirándose a sí mismo: los 64,40 dB a 80 Hz y los 62,43 dB a 125 Hz, y los 56,91 dB a 800 Hz y los 56,58 dB a 1,25 kHz, son los dos tonos colándose por las faldas de los filtros contiguos, de 26 a 34 dB por debajo; la subida lenta de 46,78 dB a 12,5 Hz a 55,15 dB a 50 Hz es la banda atenuada lejana de esos filtros más el suelo numérico. La regla práctica que se deduce: en un espectro de bandas, trata como artefacto del análisis todo lo que quede más de unos 40 dB por debajo de la banda más alta, hasta que una medida de fondo diga lo contrario. Verificación de clase de filtro es la máscara que fija cuánto tienen que caer esas faldas.
Todavía no son niveles físicos. octave_filter devuelve siempre
y, con la calibración por
defecto, toma el valor numérico de cada muestra como si fuera la presión en
pascales. Una sinusoide de amplitud unidad se lee, por tanto, como 0,7071 Pa
eficaces, es decir 90,97 dB: exactamente correcto para una señal sintética
definida en pascales, y exactamente incorrecto para una grabación, cuyas
muestras valen lo que hayan dado el convertidor y la cadena de ganancia. Hay dos
formas honestas de obtener un nivel defendible. Pasa el factor de pascales por
unidad digital obtenido con un tono de calibrador,
calibration=filters.LevelCalibration(factor=S) (consulta
Calibración y dBFS), o, cuando
la señal nunca tuvo escala física, pide LevelCalibration(dbfs=True) y lee
niveles referidos a fondo de escala digital, que salen negativos y no se pueden
confundir con un SPL.
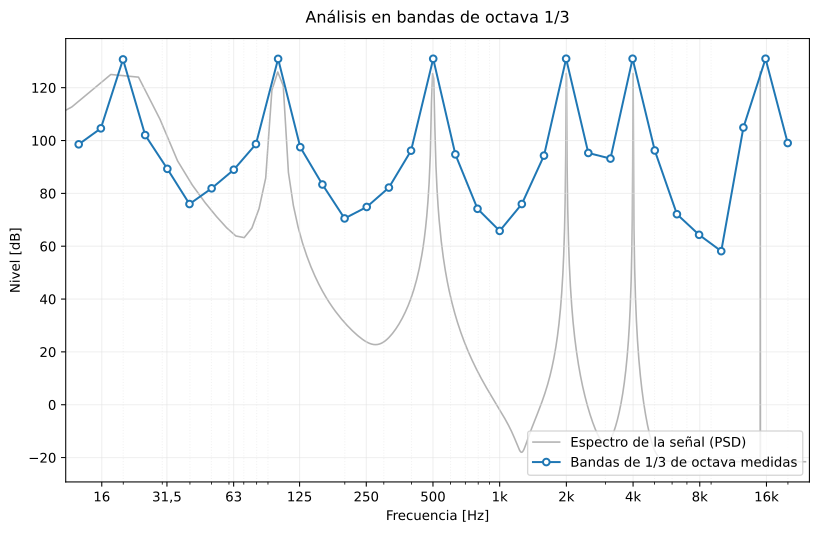
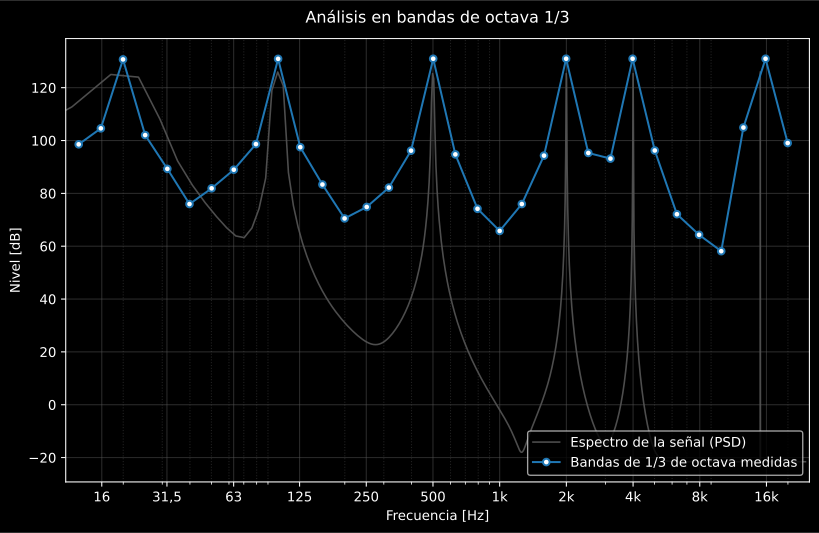
Un ejemplo más rico que el fragmento de arriba: seis tonos (20, 100, 500, 2000, 4000 y 15000 Hz) de amplitud 100, así que los niveles de banda llegan a unos 131 dB. La curva gris es la PSD de la señal en bruto, desplazada hacia abajo para compartir el eje.
Mostrar el código de esta figura
import matplotlib.pyplot as pltimport scipy.signalimport numpy as npfrom phonometry import filters
fs = 48000t = np.linspace(0, 5, 5 * fs, endpoint=False)# Seis tonos de amplitud 100, así que las bandas quedan en torno a 130 dBtones = [20, 100, 500, 2000, 4000, 15000]y = 100 * np.sum([np.sin(2 * np.pi * f * t) for f in tones], axis=0)# Aplicar el banco de filtros de 1/3 de octavafiltered = filters.octave_filter(y, fs=fs, fraction=3, limits=[12.0, 20000.0])spl, freq = filtered.levels, filtered.frequencies
# Fondo gris: la PSD de la señal en bruto (Welch), desplazada justo por debajo# de los SPL de banda para comparar ambas formas espectrales en un mismo eje.f_psd, psd = scipy.signal.welch(y, fs, nperseg=8192)psd_db = 10 * np.log10(psd + 1e-12)psd_db += np.max(spl) - np.max(psd_db) - 5
fig, ax = plt.subplots()ax.semilogx(f_psd, psd_db, color="gray", alpha=0.6, label="PSD de la señal en bruto")ax.semilogx(freq, spl, marker="o", markerfacecolor="white",            label="Bandas de 1/3 de octava")ax.set_xlabel("Frecuencia [Hz]")ax.set_ylabel("SPL [dB]")ax.set_xlim(11, 25000)ax.legend(loc="lower right")plt.show()
Esa misma llamada puede dibujar además el banco que acaba de diseñar, que es
para lo que sirve el extra [plot]: pasa
response_plot=filters.ResponsePlot(show=True) y los 33 filtros de banda
aparecen en un mismo eje antes de que vuelvan los niveles.
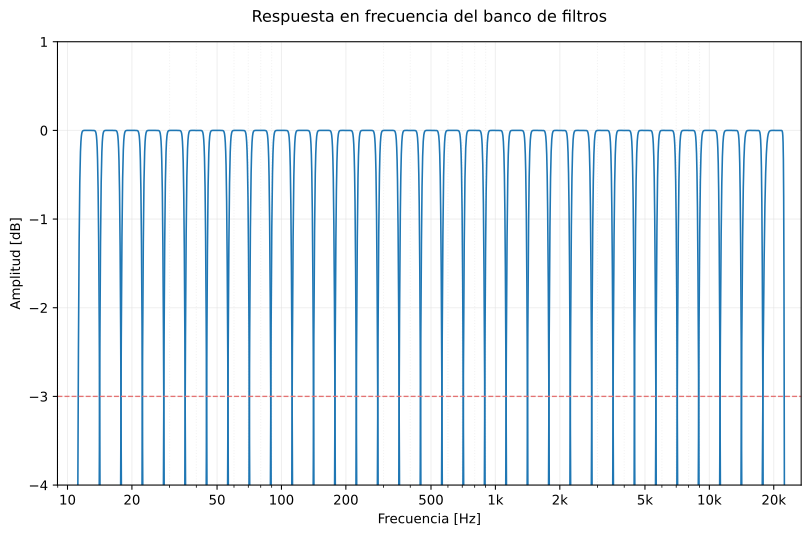
El banco por defecto: Butterworth, orden 6, tercio de octava. Cada curva cruza −3 dB en sus propios bordes de banda, que es de donde salen las faldas del párrafo anterior, y la máscara de clase 1 de IEC 61260-1 es la que fija con qué rapidez tienen que caer.
Mostrar el código de esta figura
filtered = filters.octave_filter( signal, fs=fs, fraction=3, response_plot=filters.ResponsePlot(show=True))spl, freq = filtered.levels, filtered.frequenciesLa Galería de arquitecturas de filtro tiene esta misma lámina para las otras cuatro arquitecturas.
Dar sentido físico a las muestras
Sección titulada «Dar sentido físico a las muestras»Los niveles de arriba no son una medición, porque nada conectó los números del array con una presión. Esa conexión es un único factor , la sensibilidad en pascales por unidad digital, y se obtiene grabando un calibrador de nivel conocido a través del mismo micrófono, preamplificador, interfaz y ajuste de ganancia con los que vas a medir. Un calibrador acústico de clase 1 produce 94 dB re 20 µPa a 1 kHz, que son Pa eficaces, y no 1 Pa: una diferencia de 0,02 dB que vale la pena tomarse en serio, porque se propaga a todos los niveles posteriores.
# Lo que la cadena de adquisición le hace a la presión. Este micrófono, este# preamplificador y esta interfaz entregan juntos 0.005 unidades digitales por# pascal; en una medición real nunca conoces este número, que es justo para lo# que sirve el calibrador.chain = 0.005
# Lo que el calibrador escribe en disco: 3 s de 1 kHz a 94 dB re 20 uPa.p94 = 2e-5 * 10 ** (94.0 / 20)                       # 1.0024 Pa eficacescalibrator = chain * np.sqrt(2) * p94 * np.sin(    2 * np.pi * 1000 * np.arange(3 * fs) / fs)
# ...y la medición: los mismos dos tonos por la misma cadena.recording = chain * signal
# La sensibilidad es la presión conocida entre el valor eficaz del tono grabado.cal = p94 / np.sqrt(np.mean(calibrator ** 2))print(f"{cal:.1f} Pa por unidad digital")# 200.0 Pa por unidad digital
filtered = filters.octave_filter(    recording, fs=fs, fraction=3, nominal=True,    calibration=filters.LevelCalibration(factor=cal),)spl, bands = filtered.levels, filtered.frequenciesprint(f"{bands[9]} Hz: {spl[9]:.2f} dB SPL, {bands[19]}: {spl[19]:.2f} dB SPL")# 100 Hz: 90.71 dB SPL, 1k: 90.94 dB SPL
Hay dos cosas que merece la pena notar. Los niveles calibrados son los mismos números que en el primer análisis, porque allí la señal sintética estaba definida en pascales y esta grabación es ese mismo campo visto a través de una cadena que el calibrador acaba de deshacer; pero esta vez son decibelios re 20 µPa porque los ha puesto ahí una medición, no porque lo hayamos supuesto. Y esa misma grabación leída sin el factor da 44,92 dB en la banda de 1 kHz, 46,0 dB por debajo: un nivel sin calibrar no es aproximadamente correcto, está desviado en lo que haya dado la cadena de ganancia.
En la práctica no se divide a mano. metrology.sensitivity(calibrator, target_spl=94.0, fs=fs) devuelve ese mismo factor y, de paso, comprueba la
estabilidad a corto plazo del tono grabado igual que IEC 60942 cualifica al
propio calibrador, de modo que un micrófono mal acoplado se detecta aquí en vez
de corromper en silencio todos los niveles posteriores. Calibración y
dBFS lleva esa llamada, la regla
de deriva antes/después y la alternativa digital en dBFS para señales que nunca
tuvieron escala física.
Un número en lugar de treinta y tres
Sección titulada «Un número en lugar de treinta y tres»Un sonómetro muestra un nivel, no un espectro. Sobre una señal calibrada ese nivel es una línea, porque tanto la ponderación A como el promedio energético están definidos sobre la presión de banda ancha:
weighted = filters.weighting_filter(cal * recording, fs, weighting="A")laeq = 10 * np.log10(np.mean(weighted ** 2) / (2e-5) ** 2)print(f"LAeq = {laeq:.2f} dB(A)")# LAeq = 91.02 dB(A)El nivel sin ponderar de ese mismo segundo es 93,98 dB: la ponderación A quita
casi 3 dB, prácticamente todos del tono de 100 Hz, al que la curva atenúa unos
19 dB. signals.laeq(recording, fs, calibration_factor=cal) es la forma de una
línea de las dos anteriores y aplica la ponderación internamente, así que no
apliques nunca la ponderación A a la señal antes de pasarla a una función de
nivel: eso la pondera dos veces. Las envolventes Fast y Slow, ,
y los niveles percentiles son llamadas de la misma clase: Ponderación
temporal y Niveles integrados y
estadísticos las tienen, y Construye un
sonómetro recorre la cadena entera,
del tono de calibrador a todas ellas, en una sola página.
Leer un WAV de sonómetro
Sección titulada «Leer un WAV de sonómetro»La señal sintética de arriba hacía de archivo. Con un sonómetro real tienes
dos WAV: la toma del calibrador y la medición. phonometry.io lee los
dos como mediciones: frecuencia nativa conservada, PCM entero escalado
exactamente al fondo de escala, canales primero, nada normalizado. El
Signal que devuelve lleva la frecuencia de muestreo y, en cuanto se lo
adjuntas, la calibración, así que las funciones de nivel dejan de pedirte
que repitas cualquiera de las dos:
import numpy as npfrom phonometry import io, metrology, signals
# Los dos archivos vienen del sonómetro, en este orden, por una cadena sin tocar.cal_take = io.read("calibrator.wav")          # el tono del calibrador de 94 dBcal = metrology.sensitivity(np.asarray(cal_take), target_spl=94.0,                            fs=cal_take.fs)
sig = io.read("measurement.wav", calibration_factor=cal)print(f"Leq = {float(signals.leq(sig)):.1f} dB")   # sin fs ni factor que repetir
La instalación base lee todo lo que escribe un sonómetro: PCM de 24 bits,
multicanal EXTENSIBLE, RF64 nocturno. Avisa si el archivo es una copia
comprimida de escucha en vez de una grabación lineal. Escribe el factor en el
sidecar una vez (io.write_sidecar("measurement.wav", cal)) y desde entonces
io.read("measurement.wav") vuelve calibrado sin argumento alguno.
Leer y escribir audio de medición es el
flujo completo: procedencia, bloques, escritura BWF y conversión sin
pérdidas.
Analizar un archivo de audio
Sección titulada «Analizar un archivo de audio»Una medición real son dos grabaciones, no una, y las condiciones en que se hacen deciden lo que valen los niveles:
- La misma cadena, sin tocar nada por medio. Graba primero el tono de calibrador y después la medición, con el mismo micrófono, preamplificador, interfaz y ganancia. Fija la ganancia antes del tono de calibrador y no la vuelvas a mover: el factor solo vale mientras la cadena siga como se calibró, y un mando de ganancia tocado es un error mayor que cualquier deriva.
- Deja los picos de 10 a 12 dB por debajo del fondo de escala y desactiva todo lo automático. El control automático de ganancia, la supresión de ruido, la limitación y la ecualización de la interfaz cambian todos el nivel en función del nivel, así que una muestra procesada ya no se puede convertir en un nivel de presión acústica. Una recortada tampoco.
- Graba a 48 kHz o más. A 44,1 kHz se descartan las bandas por encima de
: el banco devuelve 32 bandas que terminan en 15 848,9 Hz en lugar de
las 33 que terminan en 19 952,6 Hz de arriba. Recorta así su intervalo por
defecto sin decir nada; los límites que des y pasen de se
recortan igual, y un
filters.FilterBankWarningnombra las bandas que se quedan fuera. - Repite la comprobación del calibrador al final. La diferencia entre antes y después es la cota de deriva de todo lo capturado en medio, y un criterio habitual invalida la serie cuando supera 0,5 dB.
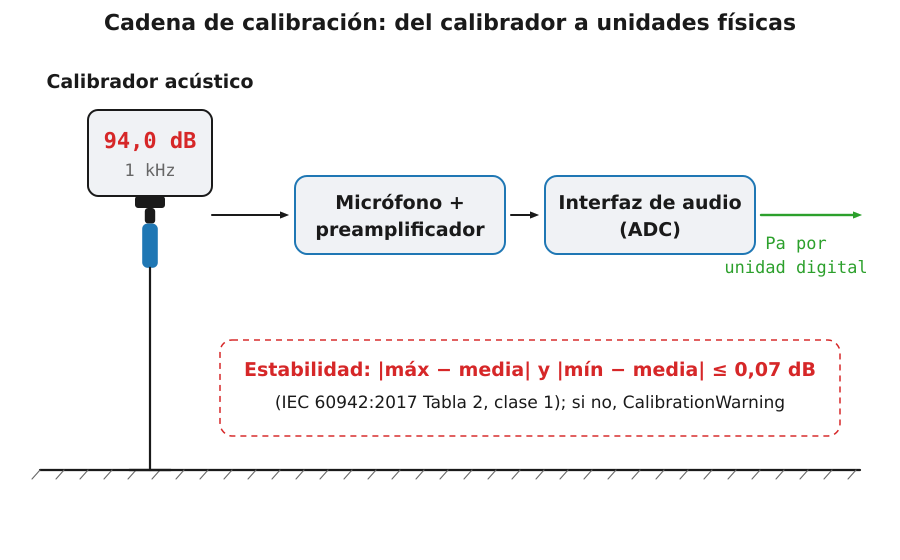
La primera de las dos grabaciones: el calibrador acoplado sobre la cápsula a 94,0 dB / 1 kHz, por el mismo preamplificador e interfaz que la medición que viene después, produciendo el factor de pascales por unidad digital del que depende todo lo que sigue.
import numpy as npfrom scipy.io import wavfilefrom phonometry import filters
# Los dos archivos salen de la misma cadena, en este orden y sin tocar nada.fs, calibrator = wavfile.read("calibrator.wav")fs, signal = wavfile.read("measurement.wav")
# wavfile.read devuelve (muestras, canales); el banco espera (canales, muestras)if calibrator.ndim > 1:    calibrator = calibrator[:, 0]if signal.ndim > 1:    signal = signal[:, 0]        # micrófono de medida en el canal 1
# Sensibilidad en pascales por unidad digital, a partir del tono de calibrador# de 94 dB. metrology.sensitivity(calibrator, target_spl=94.0, fs=fs) es la# llamada de la biblioteca, y valida además la estabilidad del tono.cal = 2e-5 * 10 ** (94.0 / 20) / np.sqrt(np.mean(calibrator.astype(float) ** 2))
filtered = filters.octave_filter(    signal, fs=fs, fraction=3, nominal=True,    calibration=filters.LevelCalibration(factor=cal),)spl, freq = filtered.levels, filtered.frequencies
Las dos trampas mecánicas de abajo pertenecen a esta ruta directa con scipy.
io.read en la sección anterior elimina las dos, escalando las muestras
enteras al fondo de escala y devolviendo los canales primero, pero conviene
conocerlas siempre que un array desnudo entre en la biblioteca:
Reduce un archivo multicanal al canal con el que mediste, o traspónlo. La
guarda de arriba no es adorno: wavfile.read devuelve un array
(muestras, canales) y el banco lee un array 2D como (canales, muestras).
Pasa un archivo estéreo tal cual y no salta nada: un array estéreo de 2400
muestras devuelve un spl de forma (2400, 33), un espectro por cada par de
muestras, y un archivo de un segundo tarda minutos en producir números sin
sentido. Consulta
Multicanal y rendimiento para el
convenio, y para el caso en que se analizan varios canales calibrados a la vez,
cada uno con su propia sensibilidad.
El audio en enteros se convierte de tipo, no se reescala. La salida de
wavfile.read se ejecuta sin error porque los enteros se convierten
internamente a float64, pero una muestra int16 de +32767 entra en el banco como
32767.0 y no como 1.0. Todos los niveles salen, por tanto,
dB por encima de los de la misma señal leída como
float: medido, una sinusoide de 1 kHz de amplitud unidad tiene su máximo en
90,94 dB y esa misma sinusoide escrita en int16 lo tiene en 181,25 dB. Divide por
el valor de fondo de escala (signal / 32768.0 para int16) antes de analizar, o
deja que lo absorba el paso de calibración: una sensibilidad determinada a
partir de una grabación de calibrador en el mismo formato entero ya lleva el
factor incorporado. Mezclar los dos, un calibrador leído como float con una
medida leída como entero, o al revés, se equivoca en 90 dB sin ningún síntoma.
Las reglas están en
Calibración y dBFS.
Un número por banda, sobre el archivo entero. octave_filter devuelve un
único nivel eficaz por banda para todo el array, quitando antes la media
(detrend=True); responde a «cuánta energía hubo en cada banda durante esta
grabación», que es la pregunta correcta para una fuente estacionaria y la
equivocada para cualquier cosa que cambie. Un paso de vehículo, una máquina que
cicla o una sala por la que alguien pasa vuelven como un promedio energético que
nadie había pedido. Si el nivel se mueve durante el registro, trocea la señal y
llama al banco por trozos, o toma la vía normalizada y usa la balística
exponencial Fast/Slow que muestra un sonómetro; mode="peak" da el pico de
banda en lugar del promedio, y un pico de banda no es el . Hay un
suelo por el otro lado: un filtro de banda necesita varios ciclos de su propia
frecuencia central para establecerse, así que un registro de un segundo dice muy
poco sobre las bandas de 12,5 o 16 Hz por muchos dígitos que devuelva.
En un cuaderno
Sección titulada «En un cuaderno»Jupyter y JupyterLab muestran el valor de la última línea de
una celda, y un resultado se muestra como una tabla de sus campos: cada uno con
su unidad cuando su nombre la lleva (_db, _hz, _m…), nombra un nivel o
una diferencia de niveles (insertion_loss y band_levels están en
decibelios) o es un eje que la API nombra por el concepto a secas (frequencies en hercios, levels en
decibelios, times en segundos), cada array en una línea con su forma y el
intervalo de sus valores, nunca los valores, así que los fotogramas de una
simulación ocupan una sola fila. Un veredicto muestra su
resultado, PASS o FAIL, en el título. Mostrar la tabla lee los campos y, en un
veredicto, passes, que puede leer otras propiedades del veredicto; no dibuja
nada ni ejecuta nada más. print() y repr() no cambian: el repr de la
dataclass, con el resumen propio de numpy para un array de más de mil valores.
Esta celda filtra un tono de 1 kHz sobre ruido en bandas de tercio de octava y termina en el resultado:
import numpy as npfrom phonometry import building, filters
fs = 48000t = np.arange(fs) / fsrng = np.random.default_rng(7)noise = np.cumsum(rng.standard_normal(fs))noise /= np.std(noise)x = 0.4 * np.sin(2 * np.pi * 1000.0 * t) + 0.05 * noise
bank = filters.octave_filter(x, fs, fraction=3, limits=[20.0, 20000.0])bank        # la última línea de la celda: el cuaderno muestra su tabla
Jupyter lo muestra bajo la celda como esta tabla:
| field | value | unit |
|---|---|---|
levels | array 31 float64, 17.125 to 82.986 | dB |
frequencies | tuple of 31 numbers, 19.953 to 19953 | Hz |
bands | None |
Un veredicto, en una celda propia, muestra su resultado en el título. Este aplica el Anexo G.4 de ISO 10140-1 a un ensayo de trasdosado sobre una pared de fábrica: las mediciones sin y con el trasdosado pueden separarse un día solo si la pared ha curado dos semanas, o al menos tres veces ese intervalo, y 2,9 días no es ninguna de las dos cosas:
check = building.check_lining_curing(curing_time_days=2.9, time_lag_days=1.0)check # un veredicto: su resultado en el título| field | value | unit |
|---|---|---|
curing_time_days | 2.9 | d |
time_lag_days | 1 | d |
required_curing_days | 14 | d |
El terminal de IPython imprime las mismas tablas como texto:
OctaveFilterResult  levels       array 31 float64, 17.125 to 82.986    dB  frequencies  tuple of 31 numbers, 19.953 to 19953  Hz  bands        Noneplot()
LiningCuringCheck: FAIL  curing_time_days      2.9  d  time_lag_days         1    d  required_curing_days  14   dplot()
La última línea nombra lo que el resultado sabe dibujar. .plot() devuelve
los ejes de matplotlib, y un cuaderno dibuja la figura bajo la celda con su
backend en línea, sin plt.show(); en un script, llama a plt.show() o
guarda la figura:
ax = bank.plot() # dibujada bajo la celda; en un script, plt.show()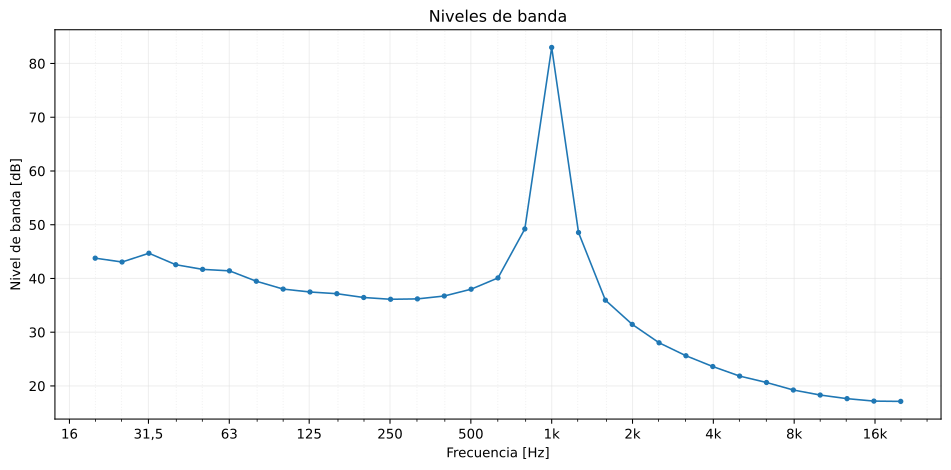
La figura que bank.plot() dibuja bajo la celda: el espectro de tercio de
octava del tono de 1 kHz sobre ruido.
Jupyter y JupyterLab sigue desde aquí: las figuras en SVG, los vídeos, las fichas y cómo se ve un aviso en una celda, y JupyterLite y Pyodide el mismo cuaderno en el navegador.
Siguientes pasos
Sección titulada «Siguientes pasos»El análisis en octavas de arriba usa phonometry.filters, uno de los veintiún
espacios de nombres de importación. La documentación los agrupa en trece
áreas, una por tema de la barra lateral, desde la psicoacústica y la acústica
de salas, edificación y vibraciones hasta el ruido ambiental, aeronáutico y
submarino, la electroacústica y la simulación de ondas FDTD. Cada objeto de
resultado expone una figura .plot(language="en"|"es") de una línea y, cuando
una norma define un formato de informe, un método .report() que genera la
ficha PDF normativa.
- Construir un sonómetro: la misma cadena de principio a fin, del tono de calibrador a , , , , los niveles percentiles y la comprobación de clase de cada etapa
- Todas las guías: el mapa, todas las guías agrupadas por tema con una línea sobre cada una
- Glosario: un símbolo, su unidad, el apartado que lo define y la guía que lo calcula
- Galería de arquitecturas de filtro: elige una arquitectura e inspecciona sus respuestas
- Calibración y dBFS: obtén valores SPL reales
- Por qué phonometry: la filosofía de diseño basada en conformidad
- Informe de conformidad: el valor esperado y el calculado de las 1899 comprobaciones
- Referencia de la API: todos los parámetros de cada función
- Bibliografía: cada obra que citan las guías, con las páginas que la citan y su enlace cuando lo tiene