Enviar una simulación a un nodo remoto
Una simulación puede calcularse en otra máquina, un nodo, cuando su petición
Compute nombra uno: una estación de trabajo con GPU, un servidor, el NAS de
debajo de la mesa. El registro de la ejecución, FDTDRun o ElasticRun, es
el mismo que toma una ejecución aquí, construido y comprobado aquí; la llamada
es la misma, fdtd_simulation(run, compute=...) o
elastic_fdtd_simulation(run, compute=...), y también lo es el registro que
devuelve. Solo esas dos funciones, y las dos que escriben un vídeo a partir de
las mismas ejecuciones, write_fdtd_animation y
write_elastic_fdtd_animation, van a un nodo. Un motor construido
directamente, FDTD2D o ElasticFDTD2D, avanza en este proceso, donde puedes
leer y escribir sus campos entre un paso y el siguiente, y rechaza una
petición que nombre un host.
Esta página explica qué pasa cuando una ejecución va a un nodo, cómo nombrarlo, cómo preparar un nodo Docker o un nodo Python, qué puede fallar y qué dice cada error, cómo seguir una ejecución, de qué se fía cada lado del otro y cuándo una ejecución allí da los números que da una ejecución aquí. El dispositivo en sí, NumPy, CuPy o torch, se elige como explica Dónde se calcula una simulación, y eso vale también en un nodo que tenga esa biblioteca: la sección 3 dice qué lleva la imagen, y la sección 4, qué necesita un nodo Python. Dónde se ejecuta el trabajo pesado reúne en un sitio los dispositivos, los nodos y los codificadores.
1. Qué pasa cuando una ejecución va a un nodo
Sección titulada «1. Qué pasa cuando una ejecución va a un nodo»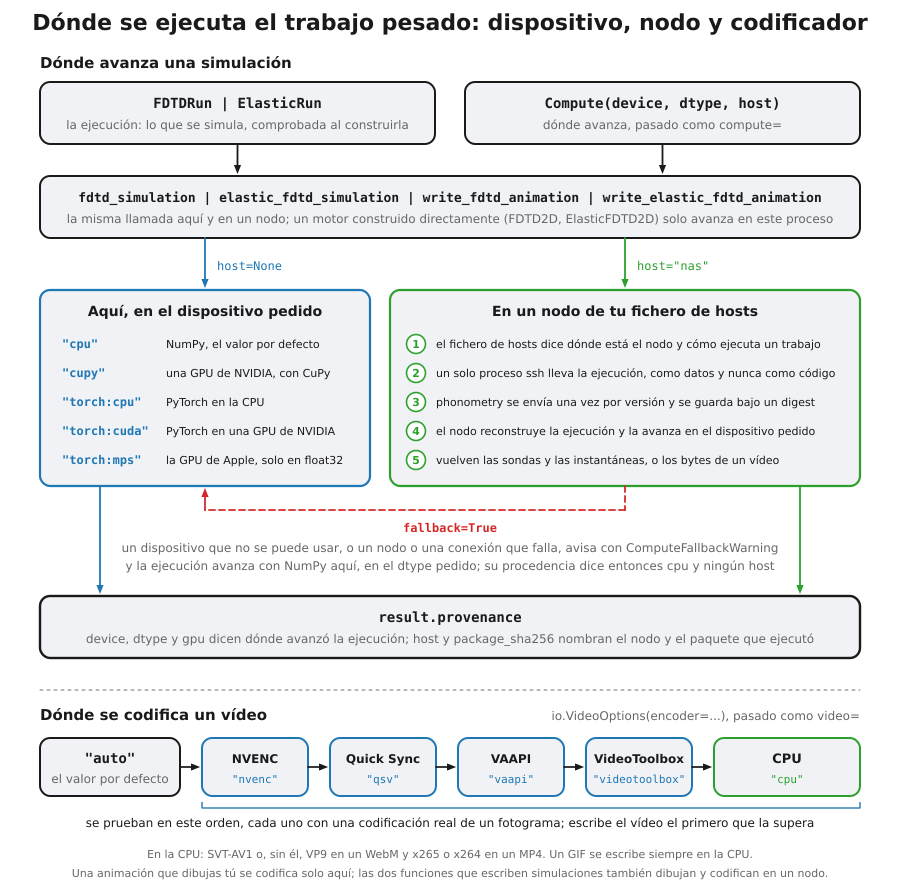
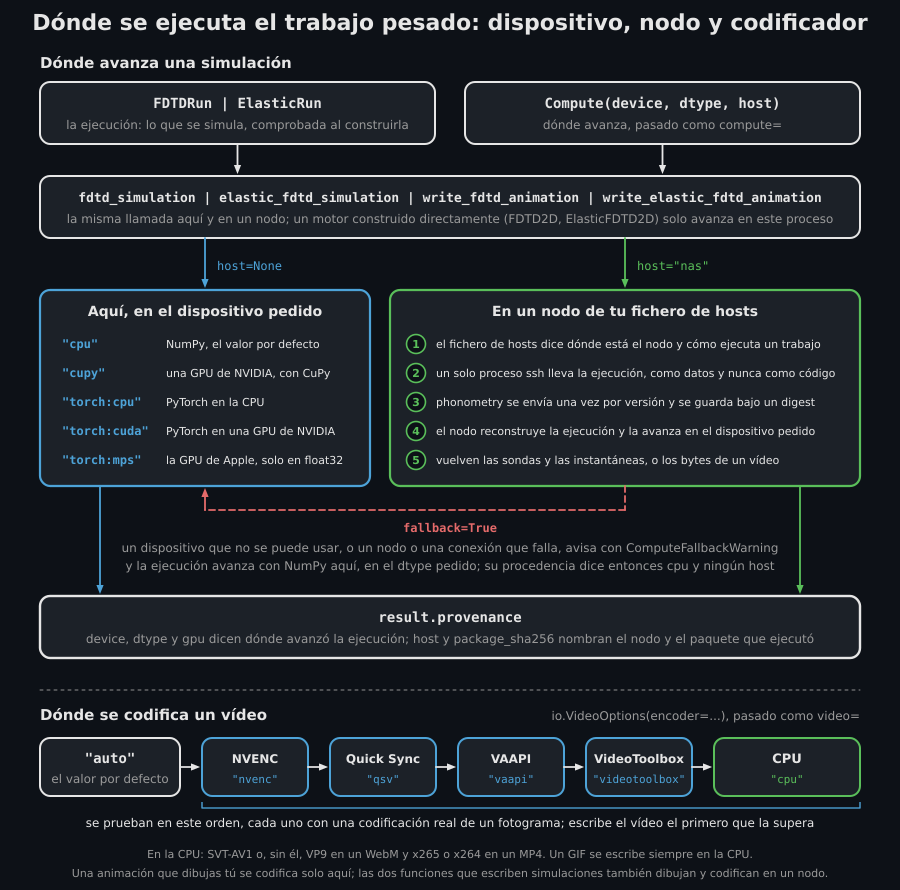
El mapa de Dónde se ejecuta el trabajo pesado. Esta sección recorre su rama derecha, los pasos numerados y la procedencia en que terminan; la flecha discontinua es la vuelta a NumPy de la sección 5.
Todo lo que puede rechazar la llamada lo hace primero aquí, antes de que se
abra ninguna conexión. La ejecución comprobó todos sus argumentos al
construirse, con el código que usa una ejecución aquí, así que un argumento
erróneo lanza el mismo TypeError o ValueError que lanza sin host.
Después, la función rechaza una ejecución que no puede viajar (la sección 5
dice cuál), y el fichero de hosts tiene que nombrar el nodo.
A partir de ahí, un solo proceso ssh lleva toda la ejecución. No hay que
instalar ni mantener en marcha ningún servidor en el nodo: le basta con su
servidor ssh. Esta máquina necesita phonometry y un cliente OpenSSH, pero no
CuPy, torch, ffmpeg ni matplotlib: una ejecución que vuelve a NumPy avanza
aquí sin ellos, y solo una función que escribe vídeo y vuelve a NumPy necesita
aquí ffmpeg y matplotlib. La ejecución viaja como datos, campo a campo, nunca
como código, y el nodo la vuelve a construir con los constructores de la
biblioteca, así que allí se comprueba otra vez. Las funciones que escriben
vídeo también viajan, llamadas como
write_fdtd_animation(path, run, compute=...), con su ejecución, su fotograma
y sus opciones de vídeo como registros: véase la sección 5 de
Escribir animaciones y simulaciones FDTD en vídeo.
El nodo ejecuta tu propio phonometry, el que tienes instalado aquí, sea cual sea el que haya instalado allí. El cliente envía sus ficheros, los que contendría un wheel suyo, una vez por versión: un nodo guarda cada versión bajo un digest de sus ficheros, que vuelve a calcular a partir de lo que recibe, y una copia de desarrollo es una versión nueva con cada cambio. Un nodo conserva los cinco paquetes usados por última vez y borra los demás, pero nunca uno usado en los últimos diez minutos ni uno que una ejecución aún retenga, así que una ejecución larga conserva su paquete por muchos otros que vayan y vengan.
El nodo ejecuta la función en el dispositivo pedido, sin ninguna vuelta a
NumPy por su cuenta, y devuelve las historias de las sondas y, cuando la
ejecución las registra (snapshot_every de su FDTDRecording o
ElasticRecording), las instantáneas, que se leen aquí en arrays
dimensionados a partir de tu petición y reservados antes de que se abra la
conexión. En una malla grande, las instantáneas son la mayor parte de lo que
cruza el enlace y de la memoria que necesita esta máquina: las reducen
snapshot_decimation, sección 7 de
Dónde se calcula una simulación, y
dtype="float32", mientras que las historias de las sondas siguen en float64.
Una función que escribe vídeo envía los bytes de su vídeo en lugar de las
instantáneas.
result.provenance.host nombra el nodo y
result.provenance.package_sha256, el paquete que se ejecutó, y
result.provenance.phonometry_version es tu propia versión, que viaja con el
trabajo: desde su caché el nodo no puede nombrar el paquete que ejecuta.
device_index es el que pediste, y el resto de la procedencia es la del nodo:
su NumPy, su biblioteca de arrays, su CUDA, su GPU. La sección 5 de
Dónde se calcula una simulación recoge
todos los campos.
2. Nombrar un nodo: el fichero de hosts
Sección titulada «2. Nombrar un nodo: el fichero de hosts»Una petición nombra un nodo con un nombre que eliges tú, y un fichero de hosts dice dónde está ese nodo y cómo ejecuta un trabajo. El fichero se lee cada vez que una ejecución nombra un host, nunca al importar:
| Sistema | Dónde está el fichero de hosts |
|---|---|
| Linux y macOS | ~/.config/phonometry/hosts.toml, o phonometry/hosts.toml bajo el directorio que nombra XDG_CONFIG_HOME, cuando esa variable contiene una ruta absoluta |
| Windows | %APPDATA%\phonometry\hosts.toml |
| cualquier sistema | la ruta que nombra PHONOMETRY_HOSTS_FILE, cuando esa variable está definida; manda sobre las filas de arriba |
Cada nodo es una tabla propia. Este fichero nombra un nodo Docker y un nodo Python:
# Una GPU en el NAS, con la imagen del nodo (sección 3).[hosts.nas]ssh = "me@nas.local"runner = "docker"image = "phonometry-node:gpu"label = "la GPU del NAS"timeout_s = 7200
# Una estación de trabajo con un entorno de Python propio (sección 4).[hosts.lab]ssh = "lab" # un alias Host de ~/.ssh/configrunner = "python"python = "venvs/node/bin/python" # relativo al directorio personal de allí| Clave | Qué contiene | Por defecto |
|---|---|---|
ssh |
el destino que toma ssh: usuario@dirección, o un alias Host de tu ~/.ssh/config |
obligatoria |
runner |
cómo ejecuta el nodo un trabajo: "docker" o "python" |
obligatoria |
image |
en un nodo Docker, la imagen que hay en el nodo | obligatoria allí |
python |
en un nodo Python, su intérprete: una ruta absoluta, una ruta relativa al directorio personal en el nodo, o el nombre de un programa, como python3, que se busca en el PATH que ve la orden que ssh ejecuta allí |
obligatoria allí |
label |
cómo nombran el nodo los mensajes y el log | su nombre |
timeout_s |
lo máximo que puede durar una ejecución allí, en segundos | sin límite |
Un nombre tiene hasta 64 caracteres, cada uno una letra, un dígito, ., _ o
-, y empieza por una letra o un dígito. Un nombre con un punto va entre
comillas en la cabecera de su tabla, porque TOML lee un punto suelto como una
tabla dentro de otra: [hosts."nas.local"] nombra el nodo nas.local, el que
pide Compute(host="nas.local"), mientras que [hosts.nas.local] sería una
tabla local dentro de un nodo nas. Una clave que la tabla no recoge, una
image en un nodo Python o un python en uno Docker, o una ruta de python
que empieza por ~ lanzan ValueError nombrando el fichero: el cliente
entrecomilla la ruta en la orden que envía, así que el shell del nodo nunca
expandiría la ~. Un fichero guardado con marca de orden de bytes, como
guarda UTF-8 el Bloc de notas de Windows, se lee como cualquier otro.
Qué necesita ssh. El cliente ejecuta el ssh de tu máquina, OpenSSH 7.6
o posterior, y una ejecución nunca pregunta nada: ssh trabaja en modo por
lotes. Es el ssh del PATH, ejecutado por la ruta completa en la que se
encuentra. En Windows, que busca un programa en el directorio de trabajo
antes que en el PATH, un ssh que esté ahí cede el paso al del PATH, y
uno que solo esté ahí se rechaza con un ComputeRemoteError: pon un cliente
OpenSSH en el PATH. Encontrado en un directorio de trabajo que el propio
PATH incluye, se ejecuta ese mismo. En Windows ssh arranca además sin
ventana de consola, así que una ejecución desde un cuaderno o desde
pythonw no abre ninguna. Accede al nodo con una clave que ssh pueda usar
sin preguntar, desde ssh-agent o sin frase de contraseña, y conéctate una
vez a mano para aceptar la clave de host del nodo. Un usuario, un puerto, una
clave o un host de salto van en un alias Host de ~/.ssh/config. Las
opciones que el
cliente le da a ssh en la línea de órdenes mandan sobre ese fichero en lo que
una ejecución no puede tener: un RemoteCommand o un LocalCommand del
alias no se ejecutan, no se reenvía nada (sección 7) y no se comparte
ninguna conexión: cada ejecución es una conexión propia, diga lo que diga el
ControlMaster del alias. Tres ajustes siguen siendo cosa del fichero,
porque los clientes anteriores a OpenSSH 8.7 los rechazan en la línea de
órdenes, y un alias que se use como nodo tiene que dejarlos en sus valores
por defecto: SessionType none deja una ejecución colgada hasta su tiempo
límite, StdinNull yes la hace fallar en el acto y
ForkAfterAuthentication yes separa la sesión y la deja fuera del alcance
del cliente.
La petición. host nombra el nodo, y timeout_s puede acotar la
ejecución; manda sobre el del fichero. Construir la petición no lee ningún
fichero ni abre ninguna conexión:
from phonometry import simulation
request = simulation.Compute(device="cupy", host="nas", timeout_s=3600)print(request.host, request.timeout_s)   # nas 3600.0
La ejecución y la llamada son las de una ejecución aquí:
run = simulation.FDTDRun( c=343.0, dx=0.01, duration_s=0.05, shape=(400, 600), sources=[simulation.GaussianPulse(ix=150, iy=200, half_width_s=3.0e-4)], recording=simulation.FDTDRecording(probes=[(450, 200)]),)res = simulation.fdtd_simulation(run, compute=request)print(res.provenance.host, res.provenance.gpu) # nas, y el nombre de la tarjetaelastic_fdtd_simulation(ElasticRun(...), compute=request) va al nodo del
mismo modo. Un script entero puede nombrar el nodo una sola vez, con un
bloque simulation.use() o con la variable de entorno PHONOMETRY_COMPUTE;
la sección 3 de
Dónde se calcula una simulación dice
cuál manda cuando más de uno nombra una ubicación. Un bloque use() aplica
su petición a cada llamada hecha dentro de él que no pase compute=:
with simulation.use(request): res = simulation.fdtd_simulation(run)La gramática de la variable es device[:index][@host][,option...]. No tiene
una opción timeout_s, así que una ejecución que envía a un nodo toma el
timeout_s del fichero de hosts, cuando el fichero lo da:
PHONOMETRY_COMPUTE=cupy@nas python study.pyPHONOMETRY_COMPUTE=cupy:1@nas,float32,fallback python study.pyUn host es un nombre del fichero, nunca usuario@dirección: el destino va en
el fichero, y Compute(host="me@nas") lanza ValueError. Un motor
construido directamente rechaza un host venga de donde venga, también de un
bloque use() o de la variable, y su ValueError dice qué pasar en su
lugar: un compute= que nombre solo el dispositivo, para avanzar aquí, o la
ejecución a su función de simulación, para calcular allí la simulación
entera.
3. Un nodo Docker
Sección titulada «3. Un nodo Docker»Un nodo Docker es una máquina Linux cuyo shell de inicio de sesión es un
shell POSIX (sh, bash, zsh: la orden que envía un cliente va
entrecomillada para un shell POSIX), con Docker instalado y tu usuario en su
grupo docker. Una ejecución en un nodo donde tu usuario no está en ese
grupo falla, y su error da la orden que te añade. Una GPU necesita además el
controlador de NVIDIA en el nodo, lo bastante reciente para el runtime de
CUDA de la imagen, y el NVIDIA Container Toolkit.
Pertenecer al grupo docker equivale a ser root en el nodo: el demonio de
Docker se ejecuta como root, y cualquier miembro puede arrancar un
contenedor que lea y escriba todos los ficheros de la máquina, como advierte
la propia documentación de Docker. El propietario del nodo solo añade a ese
grupo una cuenta SSH a la que ya le confía la máquina entera.
Un nodo puede ejecutar en su lugar Docker sin root (rootless), o Podman como tu
usuario (Podman sin root) tras una orden docker; Podman ejecutado como root
cuenta como Docker ejecutado como root. Un demonio que se ejecuta como tú no
necesita el grupo docker y ejecuta el root del contenedor como tú, mientras
que cualquier otro identificador de usuario dentro, el tuyo y el que una imagen
fije con USER incluidos, pasa a ser uno de sus identificadores subordinados,
que no puede escribir en la caché: el cliente pregunta al demonio, con
docker info, de qué tipo es, y en uno que se ejecuta como tú arranca el
contenedor como su root, con --user=0:0. Cada ejecución pasa además
--userns=host, que deja el contenedor en el espacio de nombres de usuario del
propio nodo: con un demonio que reasigna los identificadores de usuario, el
contenedor se ejecutaría, sin esa opción, como un identificador subordinado,
que con el userns-remap de Docker no puede escribir en la caché y con un
Podman configurado con userns = "keep-id" deja allí ficheros que no puedes
borrar. La orden docker de una sesión SSH no interactiva tiene que llegar a
ese demonio, lo que hace un contexto fijado con docker context use.
La imagen se construye en el nodo, desde una copia del repositorio en tu máquina:
make node-image HOST=nas # un nodo con una GPU de NVIDIAmake node-image HOST=nas TARGET=cpu # un nodo sin ellaHOST nombra una entrada de tu fichero de hosts cuyo runner es docker.
La orden envía al nodo por ssh el Dockerfile, docker/node/Dockerfile, y los
pocos ficheros que copia, docker build se ejecuta allí y la imagen toma
como etiqueta la image de la entrada. No se publica nada en ningún registro
de imágenes, y una reconstrucción sin cambios sale de la caché de Docker.
Las dos imágenes llevan Python 3.13 con las dependencias fijadas de la biblioteca y las bibliotecas que necesitan sus figuras, las fuentes DejaVu con las que se dibujan las figuras, y ffmpeg, una compilación estática que el Dockerfile fija por URL y SHA-256, con SVT-AV1, NVENC, VP9 y dav1d, así que un nodo no necesita un ffmpeg propio. La imagen para GPU añade el runtime de CUDA y CuPy 14.2.0, la versión con la que se hizo la prueba en GPU de Dónde se calcula una simulación. Ninguna de las dos imágenes lleva torch, y la imagen para CPU no lleva CuPy: un dispositivo de torch necesita un nodo Python o una imagen propia. Cada imagen base está fijada por digest.
Cada ejecución tiene un contenedor propio, que se borra cuando termina la
ejecución, sin red y con tu usuario del nodo, así que todo lo que escribe es
tuyo. Sus paquetes viven en ~/.cache/phonometry/remote en el nodo (bajo
XDG_CACHE_HOME cuando esa variable contiene una ruta absoluta), que el
contenedor monta, con los kernels que compila CuPy en cupy-kernels dentro de
ese directorio, para que una ejecución posterior no los vuelva a compilar.
Una ejecución ocupa una GPU, la que elige device_index.
Docker nunca descarga la imagen: en un nodo que no la tiene la ejecución
falla, y el error dice que la construyas.
El fichero de hosts puede nombrar una imagen propia. El cliente ejecuta como
punto de entrada del contenedor el programa de arranque con el que empieza
un nodo: el python del PATH de la imagen, que ejecuta
/usr/local/share/phonometry-node/bootstrap.py, así que esa imagen necesita
un python en su PATH y ese fichero en esa ruta (el Dockerfile lo copia
del paquete), con Python, NumPy y SciPy en los mínimos de la sección 4, y
CuPy o torch para una GPU. Su propio ENTRYPOINT no se ejecuta: nada de lo
que imprimiría puede romper la conversación con el cliente, y un entorno que
activaría no queda activo.
4. Un nodo Python
Sección titulada «4. Un nodo Python»Un nodo Python ejecuta un trabajo en un entorno de Python propio, sin Docker.
Es una máquina Linux o macOS cuyo shell de inicio de sesión es un shell
POSIX, igual que para Docker. Windows sirve como cliente, no como nodo: su
servidor OpenSSH ejecuta la orden a través de cmd.exe, que lee el
entrecomillado de otra manera.
El entorno necesita Python 3.12 o posterior, con NumPy 2.0.2 o posterior y
SciPy 1.14.0 o posterior, los mínimos de la biblioteca en su Python más
antiguo, que el nodo comprueba sea cual sea el suyo, y CuPy o torch para una
GPU, instalados como dice
Dónde se calcula una simulación. No hace
falta que phonometry esté instalado allí, y si lo está no se usa: el
intérprete se ejecuta aislado (-I), sobre el paquete que envió el cliente,
y el nodo comprueba que el phonometry que importó es ese. Un entorno por
debajo de un mínimo rechaza la ejecución, y el error nombra el mínimo y dice
que actualices el entorno.
python3 -m venv ~/venvs/node~/venvs/node/bin/pip install "numpy>=2.0.2" "scipy>=1.14.0"Pon cada requisito entre comillas: sin ellas, el >= es una redirección del
shell. Después, el fichero de hosts nombra el intérprete por su ruta,
venvs/node/bin/python desde el directorio personal o la ruta absoluta. El
cliente ejecuta ese python directamente, sin ningún script de activación
antes, así que el entorno tiene que funcionar sin él.
Un nodo que escribe vídeos
(Escribir animaciones y simulaciones FDTD en vídeo)
necesita dos cosas más: matplotlib en ese entorno, la 3.10.7 o posterior,
como pide el extra plot de la biblioteca
(~/venvs/node/bin/pip install "matplotlib>=3.10.7"), y ffmpeg en el PATH
que ve la orden que ssh ejecuta allí. La imagen de Docker de la sección 3
lleva las dos.
5. Cuando algo sale mal
Sección titulada «5. Cuando algo sale mal»| Qué salió mal | Qué se lanza | Cuándo |
|---|---|---|
| un argumento de la ejecución | TypeError o ValueError |
al construir la ejecución, igual que para una ejecución aquí |
una ejecución que no puede viajar: una fuente cuya forma de onda es un invocable distinto del .value de un GaussianPulse, CWSource o SignalSource, una subclase de uno de los registros de la biblioteca, un número entero fuera del rango de un int64, un número o un array en coma flotante de más de 64 bits (un longdouble), o un Fraction o un Decimal que la ejecución guarda tal cual, como dx=Fraction(1, 100) |
TypeError, nombrando la fuente o el campo |
al llamar a la función, antes de leer el fichero de hosts |
| un host que el fichero no nombra, o ningún fichero de hosts | KeyError |
antes de que arranque ssh |
| un fichero de hosts que es una tubería con nombre, un dispositivo o un directorio, ocupa más de 1 MiB, no se puede leer o no es TOML, o una entrada mal formada | ValueError, nombrando el fichero |
antes de que arranque ssh |
ningún cliente ssh en el PATH, aunque en Windows haya uno en el directorio de trabajo, Pyodide, un paquete que no se puede leer del disco o que contiene un fichero que ningún nodo escribiría, o un trabajo demasiado largo para la cabecera que lee un nodo (una ejecución de varios miles de fuentes puntuales) |
ComputeRemoteError |
antes de que arranque ssh |
| cualquier cosa que falle en la conexión o en el nodo | ComputeRemoteError |
cuando falla |
El mensaje de un ComputeRemoteError dice qué pasó y, cuando puede saberlo,
qué hacer: instalar aquí un cliente OpenSSH, construir la imagen en el nodo
(make node-image HOST=nas),
unirte allí al grupo docker, instalar el NVIDIA Container Toolkit, subir el
entorno a los mínimos o reconstruir la imagen, añadir tu clave al
~/.ssh/authorized_keys del nodo, aceptar su clave de host, hacer que un
script de inicio de sesión no imprima nada cuando el shell no es interactivo,
o renombrar un fichero de una copia de desarrollo cuyo nombre ningún nodo
escribiría. Su host guarda el nombre del nodo, y su node_traceback, el
traceback que imprimió el nodo cuando la ejecución lanzó un error allí, que
además va adjunto como nota, de modo que un traceback impreso aquí lo
muestra. Una conexión que se rompió añade también como nota las últimas
líneas que el nodo escribió en su salida de error estándar.
Con fallback=True, un ComputeRemoteError se convierte en un
ComputeFallbackWarning, cuyo mensaje lleva el error, y la ejecución avanza
aquí con NumPy, en el dtype pedido; su procedencia lo dice, sin host y con
el dispositivo "cpu". Una función que escribe vídeo y vuelve a NumPy
también dibuja y codifica aquí, así que necesita ffmpeg y matplotlib en esta
máquina: sin matplotlib lanza ImportError, y sin ffmpeg,
io.FFmpegNotFoundError. Todo ComputeRemoteError vuelve a NumPy, también
los que se lanzan aquí antes de que arranque ssh; un argumento erróneo, una
ejecución que no puede viajar, un host desconocido o un fichero de hosts mal
formado lanzan su error con fallback=True o sin él.
Los avisos que lanza la ejecución en el nodo se lanzan aquí, en la línea de
tu código que llamó a la función, con su propia clase: los de phonometry tal
como se publican, y los de Python y NumPy como lo que son. Un aviso de una
biblioteca que este proceso no ha importado, o de una clase que no se puede
construir a partir de su mensaje, vuelve como la clase de aviso propia de
Python de la que deriva su clase, entre ellas UserWarning,
DeprecationWarning y RuntimeWarning, con un mensaje que empieza por la
ruta de la clase: un filtro sobre esa clase lo alcanza aquí como lo haría en
el nodo. Una clase de aviso propia de Python que solo tiene un Python más
reciente en el nodo vuelve como RuntimeWarning, con el mensaje encabezado
también por la ruta de la clase.
Una interrupción, Ctrl-C o el botón de parada de un cuaderno, detiene ssh en
el acto y llega a tu código como KeyboardInterrupt, con fallback=True o
sin él. El nodo ve terminar su entrada, y su ejecución termina como mucho
30 segundos después de que su cliente cierre la conexión, normalmente en su
siguiente paso. Un cliente que desaparece sin cerrarla (un portátil que se
suspende, una red que se cae) solo se detecta cuando lo detecta el servidor
ssh del nodo. Configura su keep-alive en el sshd_config del nodo, con los
valores que usa el keep-alive del propio cliente, y recarga el servidor:
ClientAliveInterval 15ClientAliveCountMax 4Con ellos, el servidor detecta un cliente desaparecido en aproximadamente un minuto. Sin ellos, la ejecución sigue hasta el final, y una GPU queda ocupada con ella.
6. Progreso y tiempos límite
Sección titulada «6. Progreso y tiempos límite»Una ejecución remota informa al logger phonometry.simulation, que no dice
nada hasta que configuras logging:
import logging
logging.basicConfig(level=logging.INFO)
En INFO, el logger dice cuándo empieza una ejecución, cuándo se envía el
paquete (su digest y su tamaño), el paso al que ha llegado el nodo a medida
que avanza la ejecución y cuándo termina, con la etiqueta del nodo al
principio de cada línea; en DEBUG añade lo que el nodo escribe en su salida
de error estándar.
timeout_s, el de la petición o, si no, el del fichero de hosts, acota una
ejecución entera, desde la conexión hasta el resultado, medida aquí: pasado
ese tiempo se detiene ssh y la ejecución lanza ComputeRemoteError, o vuelve
a NumPy con fallback=True. Sin él, una ejecución puede durar lo que dure.
Dos cotas valen diga lo que diga: ssh detecta una conexión muerta en
aproximadamente un minuto, y deja de intentar conectar a los 30 segundos.
7. Seguridad, en los dos sentidos
Sección titulada «7. Seguridad, en los dos sentidos»La frontera es SSH. Quien puede iniciar sesión en el nodo puede ejecutar
código allí, y una ejecución remota hace exactamente eso con el paquete que
envías, así que dale al nodo la confianza que le das a cualquier máquina en
la que inicias sesión. ssh se arranca sin terminal, sin reenvío del agente,
de X11 ni de puertos, y sin delegar tus credenciales de Kerberos, diga lo que
diga ~/.ssh/config para ese host. Además del paquete y del trabajo, puede
enviar las variables de entorno que tu configuración de ssh nombra con
SendEnv o SetEnv (en Debian y Ubuntu, por ejemplo, LANG y las
variables LC_*), en la medida en que lo permita el AcceptEnv del nodo.
Un trabajo no lleva código: el nodo ejecuta el paquete que enviaste, sobre su propio Python y sus propias bibliotecas. El trabajo nombra una de las dos funciones de simulación o de las dos que escriben vídeo y lleva su ejecución como datos, que el nodo vuelve a construir con los constructores de la biblioteca, y un paquete se comprueba contra su digest antes de guardarse. El contenedor de un nodo Docker no tiene red.
El cliente no se fía de los bytes que envía el nodo. Cada cabecera y cada
array se comprueban contra lo que implica la petición, su nombre, su dtype,
su forma y su longitud, antes de leerse; no se deserializa nada con pickle;
no se importa ningún módulo que nombre el nodo salvo los del propio
phonometry; y las palabras del nodo (sus errores, tracebacks, líneas de log y
avisos) llegan a tu terminal con sus caracteres de control escapados, así que
un nodo no puede enviar una secuencia de escape a tu terminal.
8. Cuándo una ejecución allí es igual a una ejecución aquí
Sección titulada «8. Cuándo una ejecución allí es igual a una ejecución aquí»Una ejecución en un nodo avanza con el mismo código que una ejecución aquí, sobre el NumPy del nodo y su propia CPU o GPU. En una CPU da los mismos números bit a bit solo con las mismas versiones fijadas en la misma CPU: el mismo Python, NumPy y SciPy, sobre el mismo tipo de procesador y la misma biblioteca de C. Un trabajo de CI lo prueba en cada pull request, contra un nodo en la misma máquina. Entre dos máquinas, las funciones vectorizadas de NumPy, como la exponencial del perfil de la esponja, pueden redondear de forma distinta en una unidad en la última posición, porque cada CPU usa las instrucciones que tiene. En una GPU, Dónde se calcula una simulación dice qué muestra la prueba en la GPU.
9. Para quien desarrolla la biblioteca
Sección titulada «9. Para quien desarrolla la biblioteca»Los tests del camino remoto se ejecutan en cada pull request a través de un
sustituto de ssh, en Linux, macOS y Windows, y un trabajo de CI ejecuta un
nodo real en localhost: construye la imagen del nodo para CPU, la sirve a
través de un servidor ssh y exige que una ejecución allí sea igual bit a bit
a la ejecución aquí. make node-image HOST=<nombre> construye la imagen en tu
nodo desde tu copia del repositorio, con el Dockerfile y el programa de
arranque tal como los cambiaste. Tras un cambio en un motor,
make gpu-parity, ejecutado desde tu copia en esa imagen sobre la GPU del
nodo, renueva la prueba en GPU de gpu-parity.lock.
Renderizar en un nodo los clips de la documentación
Sección titulada «Renderizar en un nodo los clips de la documentación»Los clips animados de la documentación, la mayoría simulaciones que avanzan
con los motores de esta página, se pueden renderizar en el mismo nodo: con el
nodo en el fichero de hosts, PHONOMETRY_COMPUTE=cupy@<nombre> make animations
envía allí el código del último commit del repositorio, renderiza los clips
de dos en dos con la GPU y NVENC, y los trae de vuelta comprobados. La
guía para contribuir
lo explica, junto con cómo renderizarlos aquí en una CPU, que también da clips
listos para publicar.
Qué cubre esta guía
Sección titulada «Qué cubre esta guía»Cubierto
Ejecutar
fdtd_simulation,elastic_fdtd_simulationy las dos funciones que escriben vídeo,write_fdtd_animationywrite_elastic_fdtd_animation, en otra máquina por SSH, en un nodo Docker que ejecuta la imagen construida con el Dockerfile del repositorio o en un entorno de Python, con GPU o sin ella; el fichero de hosts que nombra un nodo, y elhostdeComputey dePHONOMETRY_COMPUTE; lo que comprueban el cliente y el nodo, cada uno de lo que le envía el otro; los errores que lanza una ejecución remota, la vuelta a NumPy aquí, los avisos que lanza el nodo, el progreso en el loggerphonometry.simulation, los tiempos límite y las interrupciones; y cuándo una ejecución remota da los números de una ejecución aquí.No cubierto
Un motor construido directamente,
FDTD2DoElasticFDTD2D, avanza en este proceso y no va a un nodo, y un nodo solo ejecuta las dos funciones de simulación y las dos que escriben vídeo, nunca código que elija quien llama. El único transporte es ssh. Un nodo no tiene planificador ni cola propios: dos ejecuciones enviadas a la vez se ejecutan en paralelo. La imagen del nodo se construye en el nodo y no se publica en ningún registro, y una máquina Windows no puede ser un nodo. Un nodo codifica el vídeo de una ejecución que calcula, pero no una animación dibujada aquí:io.write_videosolo se ejecuta en esta máquina.
Respuestas rápidas
Sección titulada «Respuestas rápidas»¿Cómo calculo una simulación en otra máquina?
Sección titulada «¿Cómo calculo una simulación en otra máquina?»Nombra la máquina en un fichero de hosts, dale la imagen del nodo
(make node-image HOST=nas) o un entorno de Python con NumPy, SciPy y, para
esta petición de GPU, CuPy, y pasa
compute=simulation.Compute(device="cupy", host="nas") a fdtd_simulation o
a elastic_fdtd_simulation, o fija PHONOMETRY_COMPUTE=cupy@nas. La
ejecución, la llamada y el resultado son los de una ejecución aquí, y
result.provenance.host nombra el nodo.
¿Da los mismos números una ejecución remota?
Sección titulada «¿Da los mismos números una ejecución remota?»Con las mismas versiones fijadas en la misma CPU, bit a bit, como prueba un trabajo de CI en cada pull request. Entre dos máquinas, NumPy puede redondear una función vectorizada, como la exponencial del perfil de la esponja, de forma distinta en una unidad en la última posición. En una GPU, la prueba de la página sobre dónde se calcula una simulación dice cómo se comparan los campos con los de NumPy.
¿Qué necesita el nodo?
Sección titulada «¿Qué necesita el nodo?»Un servidor ssh en el que puedas iniciar sesión con una clave, en Linux o
macOS con un shell POSIX de inicio de sesión, y o bien Docker con la imagen
del nodo (y, para una GPU, el controlador de NVIDIA y el NVIDIA Container
Toolkit), o bien un Python 3.12 o posterior con NumPy y SciPy en los mínimos
de la biblioteca (y CuPy o torch para una GPU). Para escribir vídeos, un nodo
Python necesita además matplotlib, y ffmpeg en su PATH; la imagen de Docker
lleva los dos. No hace falta que phonometry esté instalado allí: el cliente
envía el suyo. Esta máquina necesita phonometry y un cliente OpenSSH, pero no
CuPy, torch, ffmpeg ni matplotlib: una ejecución que vuelve a NumPy avanza
aquí sin ellos, y solo una función que escribe vídeo y vuelve a NumPy necesita
aquí ffmpeg y matplotlib.